Econometrics-Lesson2:概率论与数理统计基础 & 回归分析概述
本节考核与课程说明#
WARNING
- 课堂签到码:7230。
- 老师明确说明:上一讲的绪论 / 建模部分很重要,但历年考试分值通常只有约 1–2 分。
- 假设检验部分,老师强调考试中重点掌握临界值法;实际论文研究通常更多使用 p-value 法。
- “相关分析与回归分析的区别”老师提到过去曾作为简答题考过,建议掌握概念和典型例子。
- 本节未听到布置课后作业或测试。
本节课可以分成三块:
-
绪论回顾:计量经济模型是怎样建出来的
- 变量怎么选
- 函数形式怎么定
- 参数应当满足什么经济学预期
- 数据需要满足什么质量要求
- 模型估计后如何检验与应用
-
计量经济学预备知识:概率论与数理统计
- 随机试验、条件概率、随机变量
- 分布函数、期望、方差、协方差、相关系数、矩
- 正态分布、χ2 分布、t 分布、F 分布
- Chebyshev 不等式、大数定律、中心极限定理
- 样本、统计量、点估计、区间估计、假设检验
-
第二章开头:一元线性回归模型 §2.1 回归分析概述
- 确定性关系与统计依赖关系
- 相关分析与回归分析
- 条件分布、条件期望
- 总体回归线与总体回归函数(PRF)
本节最后停在:
E(Y∣X)=f(X)若进一步假定总体回归函数为线性:
E(Y∣X)=β0+β1X样本回归函数(SRF)留到下一节课。
一、绪论回顾:计量经济模型怎么建立#
本节前约 28 分钟,老师重新梳理了上一讲的建模思想。
最核心的逻辑是:
经济理论提出关系 → 选择变量 → 确定函数形式 → 对参数提出经济学预期 → 找到可用数据 → 选择估计方法 → 对模型进行检验 → 用模型分析与预测。
1. 从经济学理论确定变量#
老师继续使用 居民消费行为 作为例子。
根据凯恩斯消费理论,居民消费支出会受到可支配收入影响,因此最基本的变量是:
最简单的一元模型可写为:
Y=β0+β1X+μ其中,可支配收入是消费支出的一个主要解释因素。
但现实中消费还可能受到价格等因素影响,因此进一步可能写成多元模型:
Y=f(X,Price,⋯)TIP建模第一问始终是:
哪些变量应进入模型?
答案应当优先来自经济学理论,而不能只看数据里“谁和谁相关”。
2. 确定变量之间的函数形式#
经济理论往往只能告诉我们变量之间“有关系”,却未必直接给出精确函数形式。
常见方法:
- 先根据理论提出候选形式;
- 画散点图观察关系形态;
- 比较不同函数形式对历史数据的拟合效果。
例:消费与收入#
如果随着收入上升,消费大体单调上升,可以先尝试:
Y=β0+β1X+μ例:税率与税收收入#
老师举了一个典型的非线性例子:
- 税率从较低水平上升时,政府税收收入可能增加;
- 税率过高后,生产和经营激励下降,税基可能缩小;
- 因此税率与税收收入可能呈现“先升后降”的关系。
可用二次函数近似:
Y=β0+β1X+β2X2+μ,β2<0这时散点图会比单纯的线性模型更能帮助判断函数形式。
TIP建模第二问:
进入模型的变量之间,以什么函数形式发生关系?
3. 对参数形成经济学预期#
参数估计前就应当根据经济理论形成预期。
老师把这种预期分成三类:
(1)符号#
消费模型中:
β1>0因为收入增加通常会带来消费支出增加。
(2)大小#
若 β1 表示边际消费倾向,则通常预期:
0<β1<1收入每增加 1 单位,消费增加量应当为正,同时一般低于新增收入本身。
(3)参数之间的关系#
以 Cobb-Douglas 生产函数为例:
Y=AKαLβ若假设规模报酬不变,则:
α+β=1这里检验的已经不仅是单个参数,还包括参数之间的约束关系。
4. 模型随研究环境变化#
老师反复强调:
同一种经济行为,在不同时间、地区、行业和市场环境下,合适的模型可能不同。
例:生产函数与市场环境#
在产品供不应求时,企业生产更受内部投入约束,传统生产函数可能较适用。
当市场转为明显的买方市场、供过于求时:
会成为不可忽略的因素。
因此,即使研究的都是“生产”,模型设定也应随环境改变。
5. 变量必须能够被测度#
理论上重要的变量,如果没有可获得的数据,实际建模会遇到困难。
例:企业创新#
创新可以从不同角度测度:
投入端
产出端
例:企业管理水平#
管理水平显然会影响企业效率,但它难以直接量化。
这类变量的难点在于:
- 经济含义明确;
- 需要找到能够真正代表这一概念的可观测指标。
WARNING变量的“可测度性”不能只理解成“有一个数字”。
这个数字还必须与模型中该变量的经济含义一致。
6. 数据类型与数据质量#
老师复习了三类数据:
横截面数据 Cross-sectional Data#
同一时期,不同个体的数据。
例:
2025 年中国各省 GDP。
时间序列数据 Time-series Data#
同一个体或总体,在不同时间点的数据。
例:
2000–2025 年中国 GDP。
面板数据 Panel Data#
同时具有横截面和时间两个维度。
例:
2000–2025 年中国各省 GDP。
数据质量主要从以下方面判断:
(1)完整性#
例如研究 2000–2025 年的时间序列,中间年份不能无故缺失。
(2)准确性#
老师讲了两个层面:
狭义准确性
数据本身真实、记录正确。
经济含义上的准确性
数据指标应当真正对应模型中的概念。
例如研究“管理水平”,简单拿“职工人数”代替,经济含义很可能不匹配。
(3)可比性#
比较对象需要处在可比较口径下。
时间序列尤其要注意:
(4)一致性#
X 与 Y 应来自同一研究对象、相同统计范围。
例如研究大学生消费行为:
- 收入变量应来自大学生;
- 消费支出变量也应来自大学生。
7. 估计、检验与应用#
有了模型和数据后,进入参数估计。
老师列举了后续课程会接触的方法:
- 普通最小二乘法 OLS
- 极大似然法 MLE
- 两阶段最小二乘法 2SLS
- 广义矩估计 GMM
估计结束后,需要检验模型。
结合上一讲与教材的框架,可以概括为:
- 经济意义检验
- 统计检验
- 计量经济学检验
- 模型预测检验
模型通过检验后,可用于:
二、概率论基础#
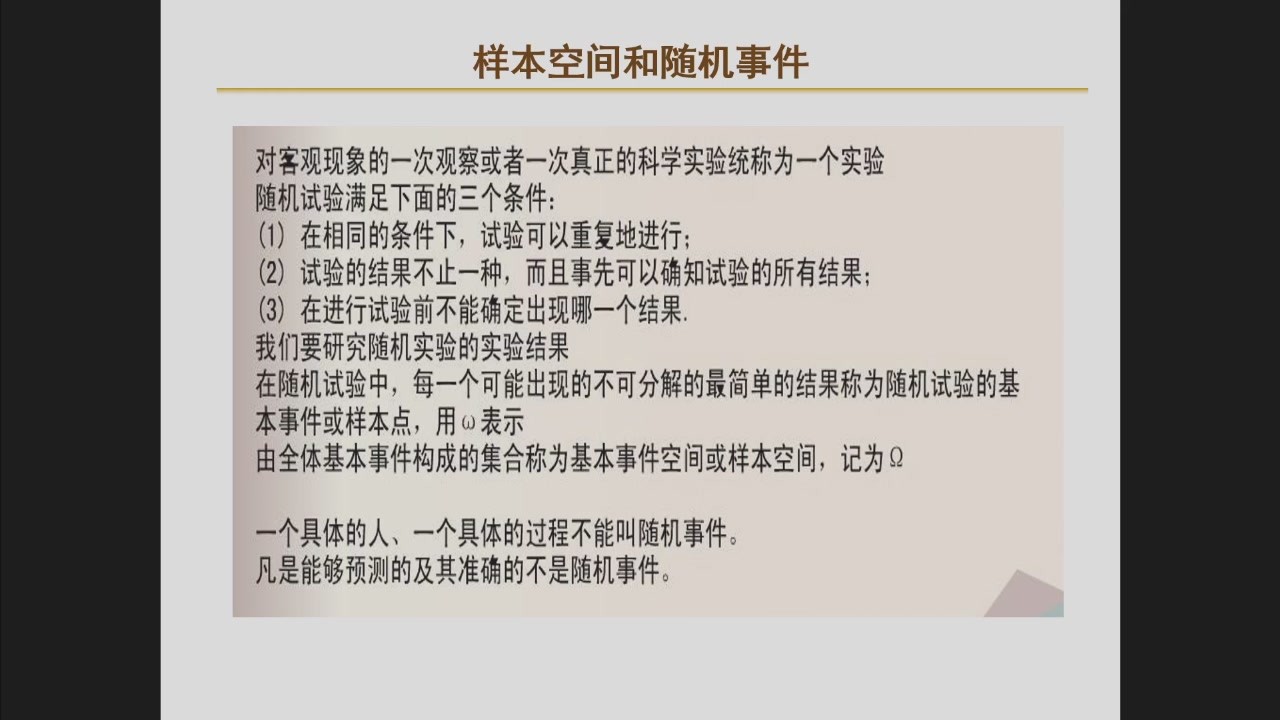
1. 样本空间与随机事件#
随机试验#
一个试验称为随机试验,课堂上给出的三个条件是:
- 在相同条件下可以重复进行;
- 所有可能结果事先已知;
- 每一次试验前无法确定究竟出现哪一个结果。
例:掷一次骰子#
可能结果:
Ω={1,2,3,4,5,6}其中:
- 每一个结果称为样本点 / 基本事件;
- 所有可能结果构成的集合称为样本空间 Ω。
随机事件#
样本空间的一个子集就是事件。
例如:
A={2,4,6}可以表示“掷出偶数”。
2. 概率、条件概率与独立性#
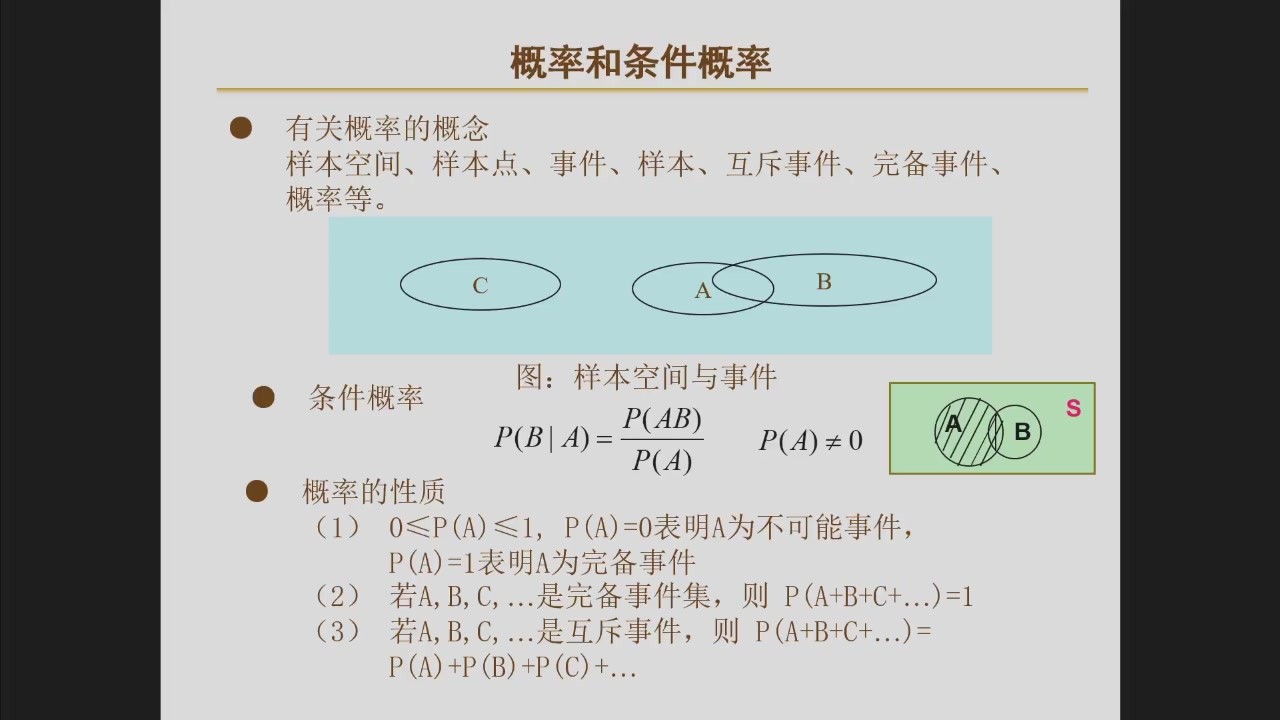
条件概率#
在事件 A 已经发生的条件下,事件 B 发生的概率:
P(B∣A)=P(A)P(A∩B),P(A)>0直观理解:
原来的样本空间被缩小到 A,然后在 A 内看同时属于 B 的部分占多大比例。
独立事件#
若 A 与 B 相互独立,则:
P(A∩B)=P(A)P(B)于是:
P(B∣A)=P(B)含义是:
是否知道 A 已经发生,不改变 B 的发生概率。
3. 随机变量与概率分布#
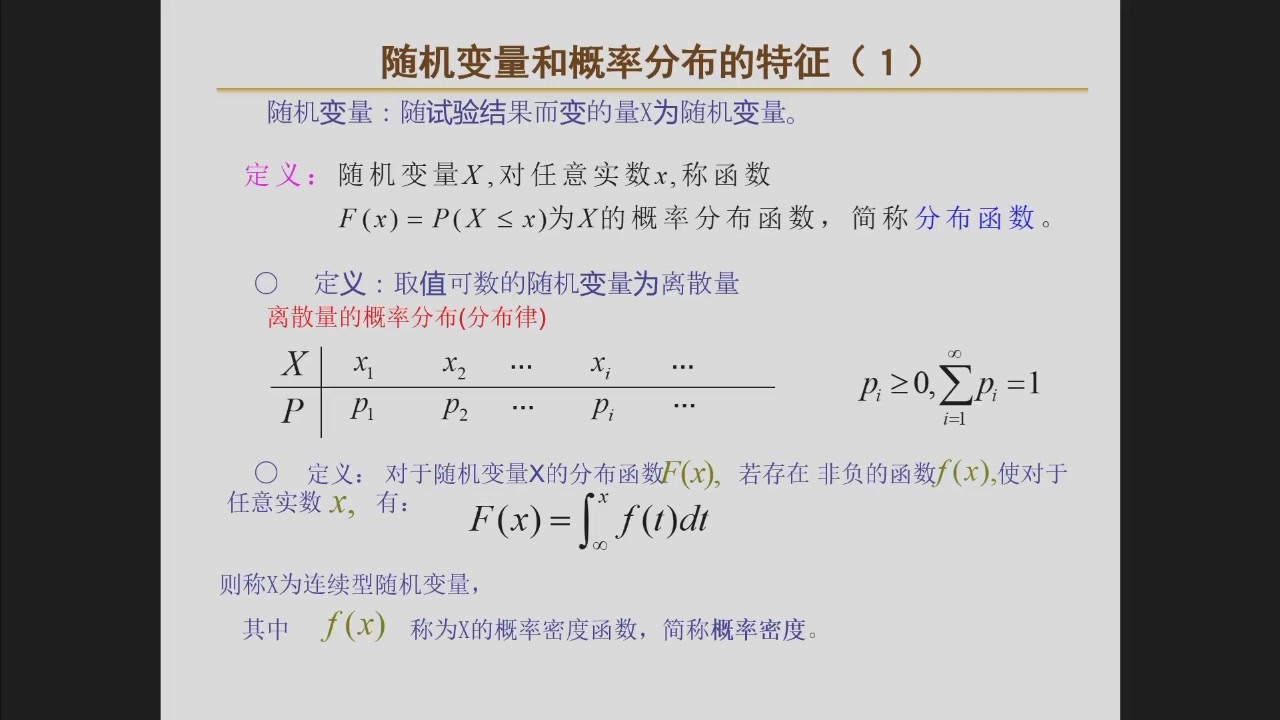
随机变量#
随机变量 X 把随机试验的结果映射成实数。
严格写法:
X:Ω→R例:掷骰子#
X 可以定义为“朝上的点数”,于是:
X∈{1,2,3,4,5,6}由于取值是离散的,因此它是离散型随机变量。
离散型与连续型#
离散型随机变量#
只能取有限个或可数个值。
例:
概率分布可写成:
P(X=xi)=pi,pi≥0,i∑pi=1连续型随机变量#
可以在某一区间连续取值。
老师用身高举例:
- 实际身高可写成很多位小数;
- 日常测量显示为 1.72 m 等,是测量精度和四舍五入的结果;
- 理论上身高可作为连续型变量处理。
分布函数 CDF#
课堂 PPT 写为:
F(x)=P(X<x)更常用的标准定义是:
F(x)=P(X≤x)WARNING对连续型随机变量,P(X=x)=0,所以 P(X<x)=P(X≤x)。
对离散型随机变量,两者一般不同。因此正式写笔记时建议使用:
F(x)=P(X≤x)
掷骰子例:x=2.5#
F(2.5)=P(X≤2.5)=P(X=1)+P(X=2)公平骰子下:
F(2.5)=61+61=31如果 x 很大,例如 x=10000:
F(10000)=1若 x=0:
F(0)=0连续型随机变量的密度函数#
若存在概率密度函数 f(x),则:
F(x)=∫−∞xf(t)dt并且:
P(a<X≤b)=∫abf(x)dx多维随机变量#
一颗骰子可形成一维随机变量。
两颗骰子同时投掷,可得到二维随机变量:
(X,Y)三颗骰子对应三维随机变量。
4. 随机变量的数字特征#
老师反复强调:
期望、方差描述的是随机变量的分布特征。
4.1 期望 Expectation#
离散型:
E(X)=i∑xiP(X=xi)连续型:
E(X)=∫−∞+∞xf(x)dx骰子例#
公平骰子:
E(X)=61(1+2+3+4+5+6)=3.5期望的性质#
E(c)=cE(cX)=cE(X)E(X+Y)=E(X)+E(Y)E(X−Y)=E(X)−E(Y)若 X,Y 独立:
E(XY)=E(X)E(Y)老师对 E(c)=c 的解释#
可以把常数 c 看成一个退化随机变量:
P(X=c)=1例如把骰子六个面全部写成 1,不论怎样掷,结果都为 1,因此:
E(X)=1
4.2 方差 Variance#
设:
μ=E(X)则:
Var(X)=E[(X−μ)2]离散型:
Var(X)=i∑(xi−μ)2P(X=xi)连续型:
Var(X)=∫−∞+∞(x−μ)2f(x)dx方差衡量随机变量围绕均值的离散程度。
常用恒等式:
Var(X)=E(X2)−[E(X)]2性质:
Var(c)=0Var(aX)=a2Var(X)Var(aX+b)=a2Var(X)一般地:
Var(X+Y)=Var(X)+Var(Y)+2Cov(X,Y)Var(X−Y)=Var(X)+Var(Y)−2Cov(X,Y)若 X,Y 独立,且方差存在,则:
Cov(X,Y)=0因此:
Var(X±Y)=Var(X)+Var(Y)
4.3 协方差 Covariance#
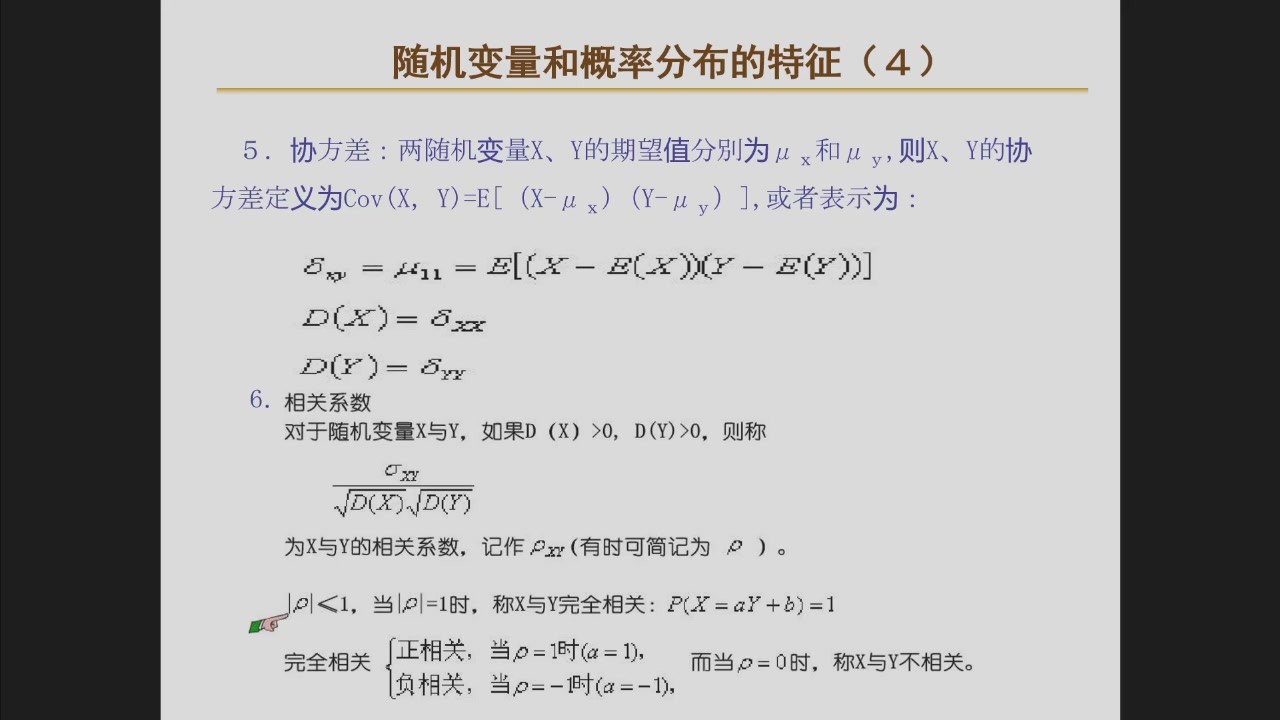
定义:
Cov(X,Y)=E[(X−E(X))(Y−E(Y))]也可以写为:
Cov(X,Y)=E(XY)−E(X)E(Y)协方差的符号反映两个变量的共同变动方向:
- Cov(X,Y)>0:总体上同向变化;
- Cov(X,Y)<0:总体上反向变化;
- Cov(X,Y)=0:线性共同变动部分为 0。
老师从散点图四个象限解释:
- X−Xˉ 与 Y−Yˉ 同号的点较多,乘积偏正;
- 异号的点较多,乘积偏负。
4.4 相关系数 Correlation Coefficient#
对协方差进行标准化:
ρXY=Var(X)Var(Y)Cov(X,Y)其中:
−1≤ρXY≤1
- ρ=1:完全正线性相关;
- ρ=−1:完全负线性相关;
- ρ=0:无线性相关。
WARNING课堂 PPT 中把下列若干命题写成“等价”,并在讲解中将“协方差为 0”与“独立”联系起来。
严格来说:
X,Y 独立⇒Cov(X,Y)=0在一般情形下,反方向不成立。
同样:
ρXY=0只说明无线性相关,两个变量仍可能存在明显的非线性依赖关系。
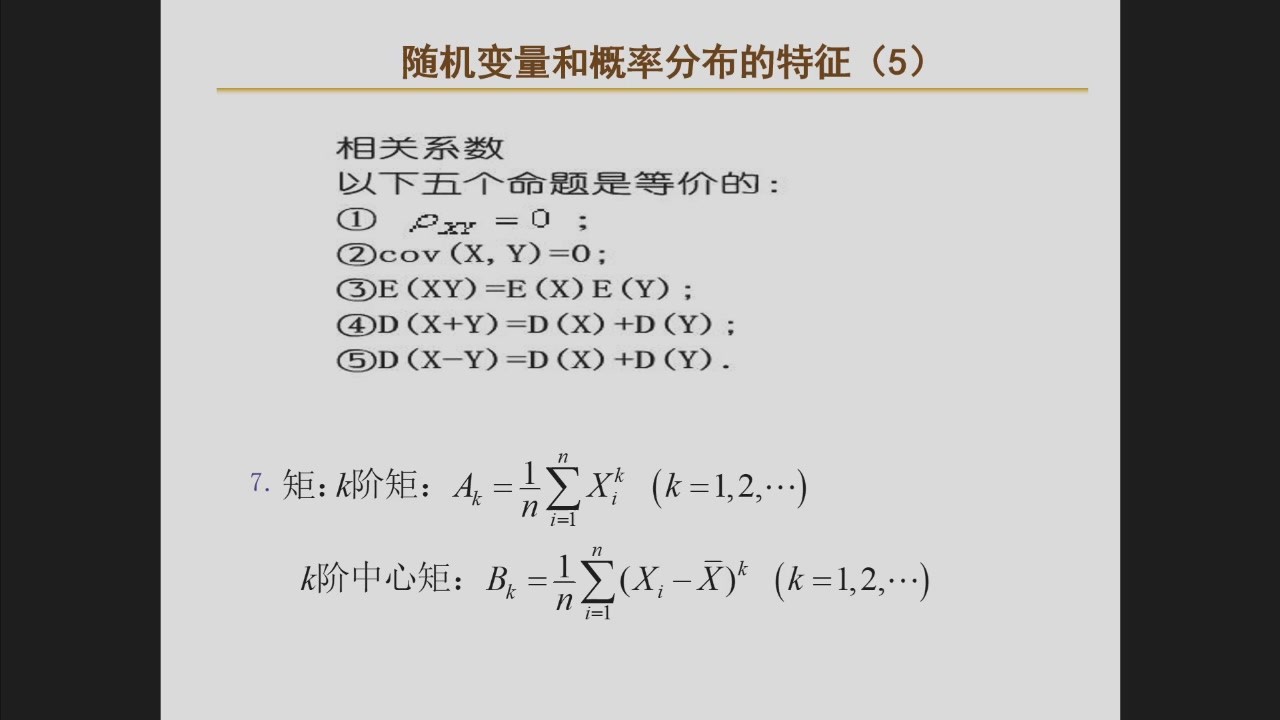
4.5 矩 Moment#
k 阶原点矩:
Ak=n1i=1∑nXik总体对应形式为:
E(Xk)k 阶中心矩:
Bk=n1i=1∑n(Xi−Xˉ)k总体对应形式为:
E[(X−E(X))k]特别地:
5. 四个重要概率分布#
5.1 正态分布 Normal Distribution#
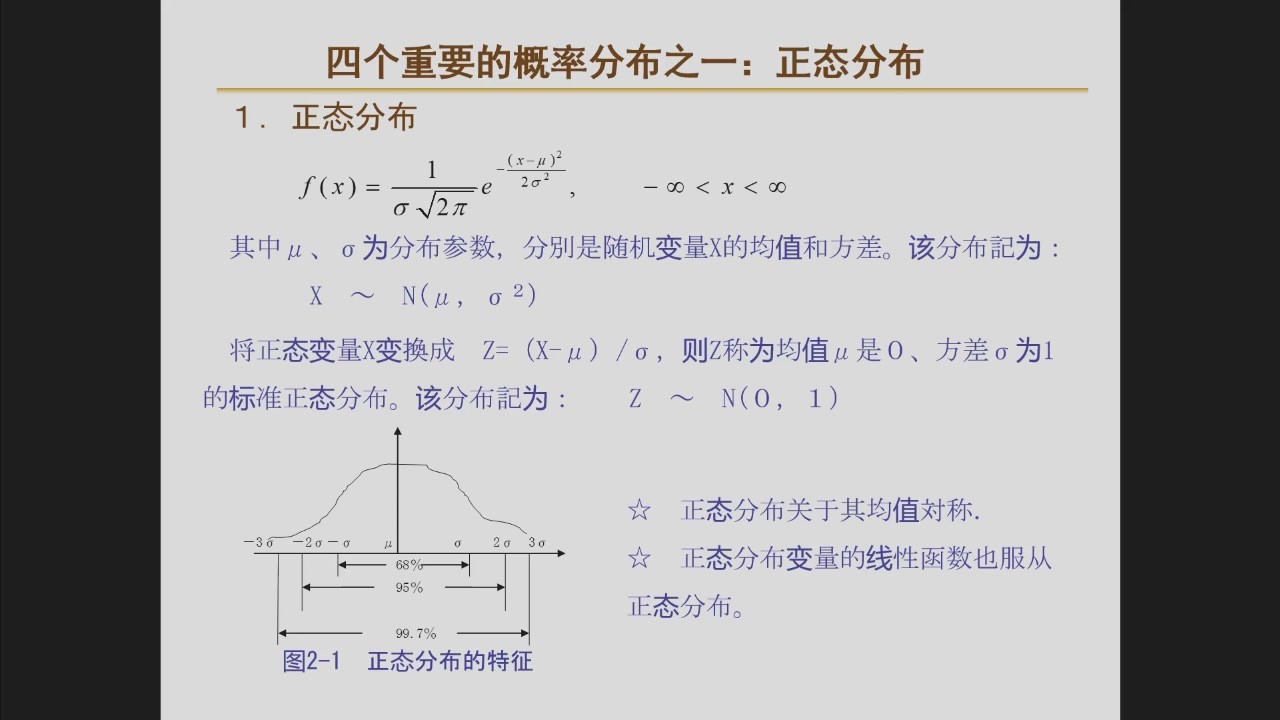
若:
X∼N(μ,σ2)其密度函数:
f(x)=σ2π1exp[−2σ2(x−μ)2]其中:
- E(X)=μ
- Var(X)=σ2
- σ 是标准差
标准化:
Z=σX−μ则:
Z∼N(0,1)正态分布特点:
- 关于 μ 对称;
- 由 μ 和 σ2 完全确定;
- 正态变量的线性组合仍服从正态分布;
- 经验法则:
P(∣X−μ∣≤σ)≈68%P(∣X−μ∣≤2σ)≈95%P(∣X−μ∣≤3σ)≈99.7%WARNINGPPT 上有一处表述容易混淆:σ 应理解为标准差,σ2 才是方差。
上分位数#
若:
Z∼N(0,1)定义上 α 分位数 zα:
P(Z>zα)=α显著性检验和置信区间中会频繁使用。
5.2 χ2 分布#
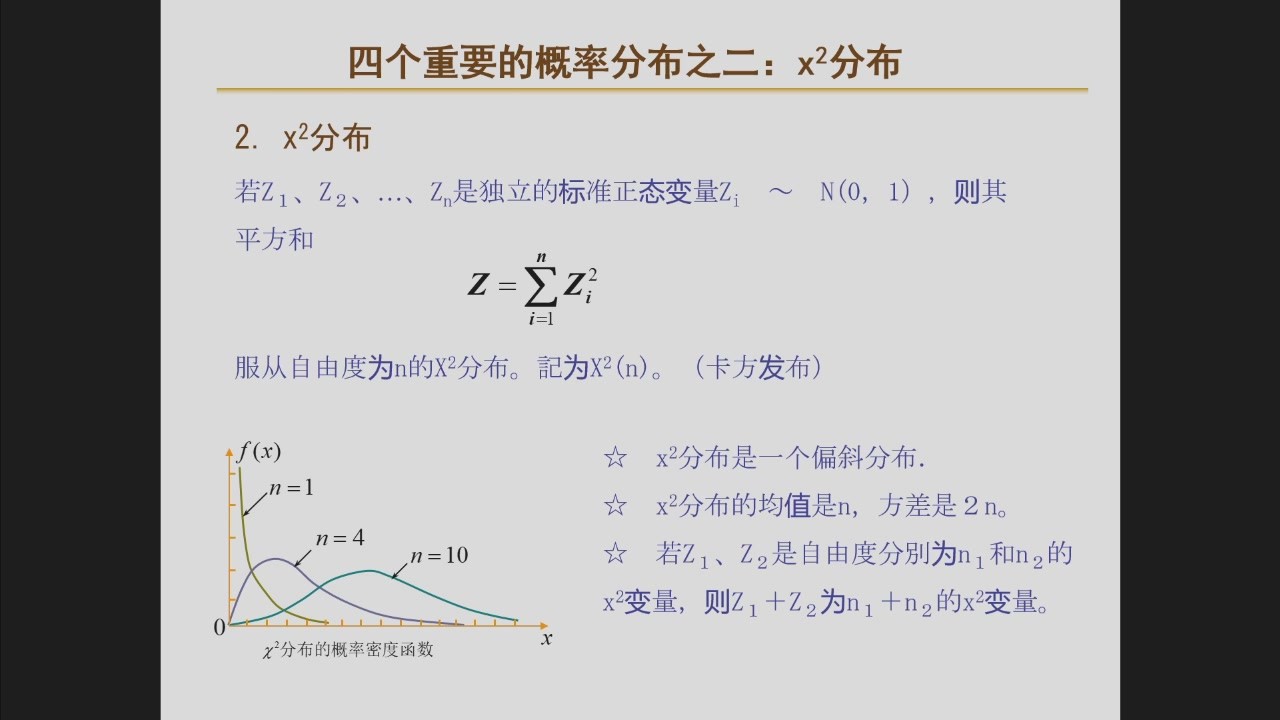
若:
Z1,Z2,⋯,Zn∼i.i.d.N(0,1)则:
Q=i=1∑nZi2∼χ2(n)其中 n 为自由度。
重要性质:
E(Q)=nVar(Q)=2nχ2 分布:
- 取值非负;
- 一般右偏;
- 自由度增大时逐渐更接近对称。
自由度#
老师特别强调自由度概念。
直观理解:
如果 n 个量之间存在 1 个独立的线性约束,能够自由变化的维数会少 1。
例如:
Z1+⋯+Zn=0只需自由确定其中 n−1 个,最后一个由约束决定,因此自由度为 n−1。
5.3 t 分布#
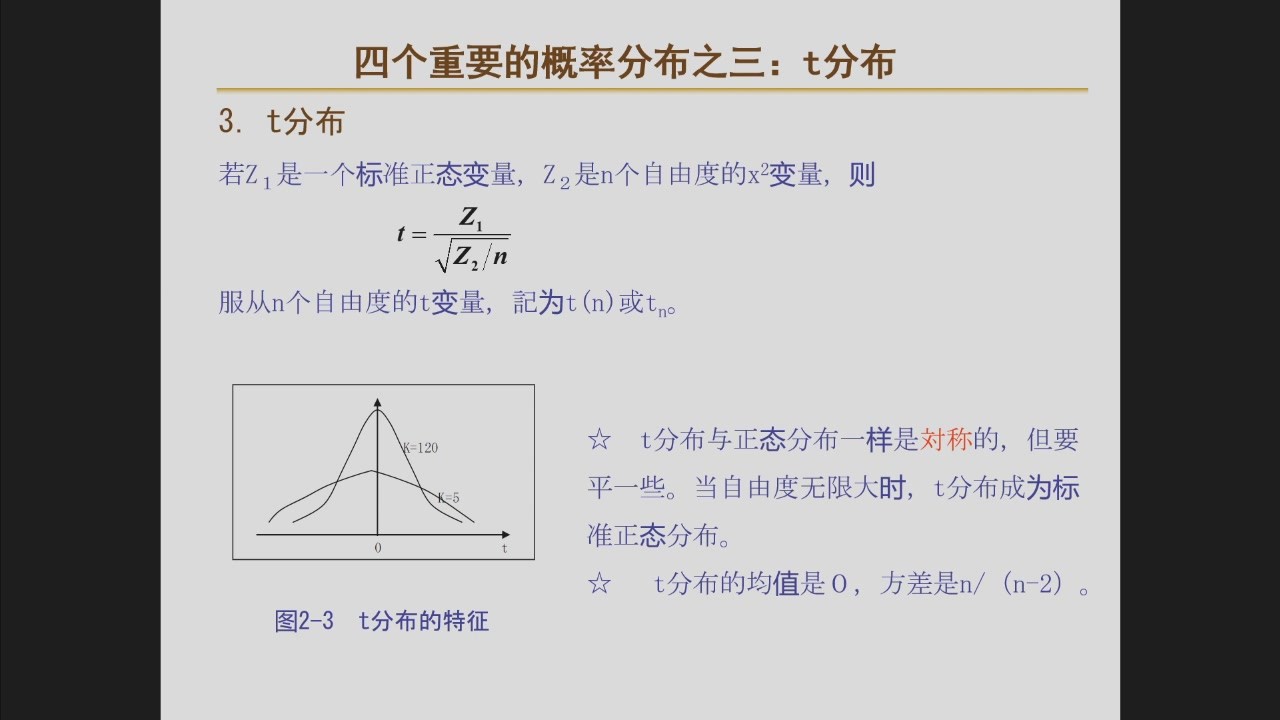
若:
Z∼N(0,1)Q∼χ2(n)且 Z 与 Q 独立,则:
T=Q/nZ∼t(n)特点:
- 关于 0 对称;
- 尾部比标准正态分布更厚;
- 当 n→∞:
t(n)⇒N(0,1)当 n>2 时:
E(T)=0,Var(T)=n−2n
5.4 F 分布#
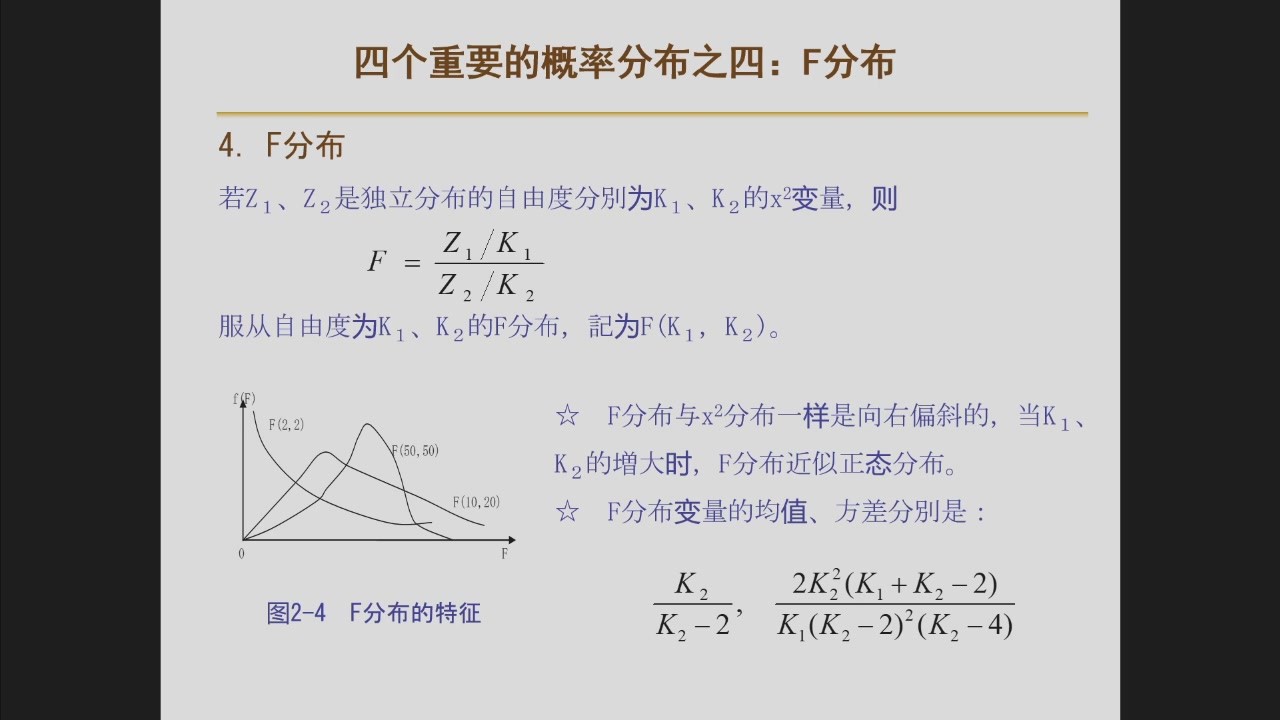
若:
Q1∼χ2(k1),Q2∼χ2(k2)相互独立,则:
F=Q2/k2Q1/k1∼F(k1,k2)F 分布:
后续多元回归的总体显著性检验会大量使用 F 分布。
6. Chebyshev 不等式、大数定律与中心极限定理#
6.1 Chebyshev 不等式#
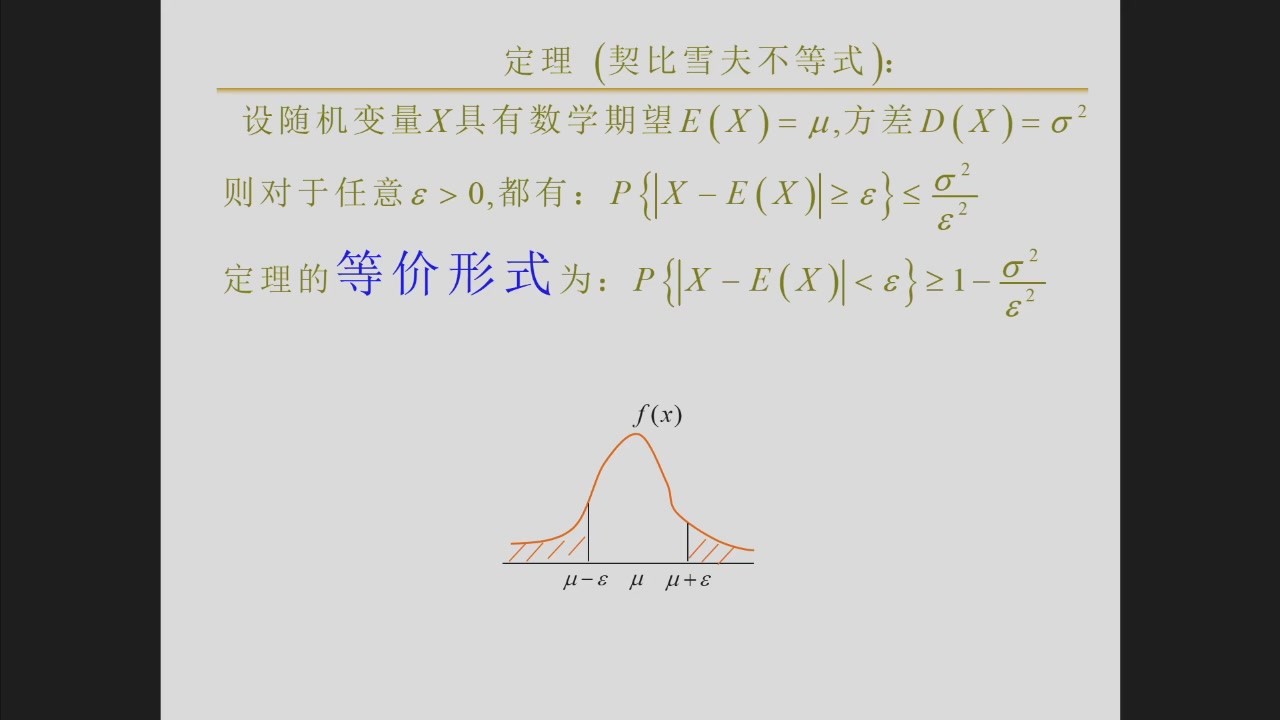
若:
E(X)=μ,Var(X)=σ2<∞则对任意 ε>0:
P(∣X−μ∣≥ε)≤ε2σ2等价地:
P(∣X−μ∣<ε)≥1−ε2σ2若取:
ε=kσ则:
P(∣X−μ∣≥kσ)≤k21例如 k=3:
P(∣X−μ∣≥3σ)≤91Chebyshev 不等式的重要之处在于:
不要求事先知道随机变量究竟服从哪一种具体分布。
只要均值和方差存在,就能给出偏离均值的概率上界。
6.2 大数定律 Law of Large Numbers#
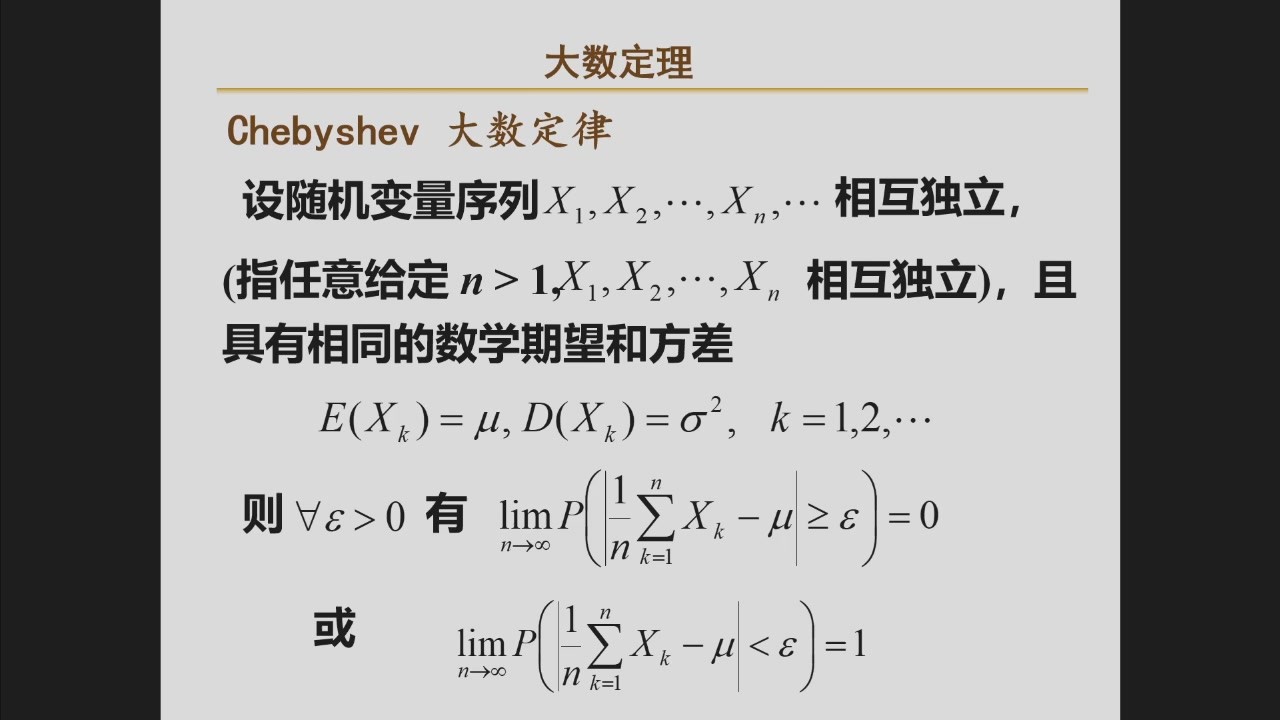
若:
X1,X2,⋯相互独立,且:
E(Xi)=μ,Var(Xi)=σ2则:
Xˉn=n1i=1∑nXi满足:
Xˉnpμ即:
∀ε>0,n→∞limP(∣Xˉn−μ∣≥ε)=0直观含义:
样本越来越大时,样本平均值会越来越集中到总体均值附近。
老师特别提醒:
“大数”指大量重复试验 / 大样本,而非“某个数值很大”。
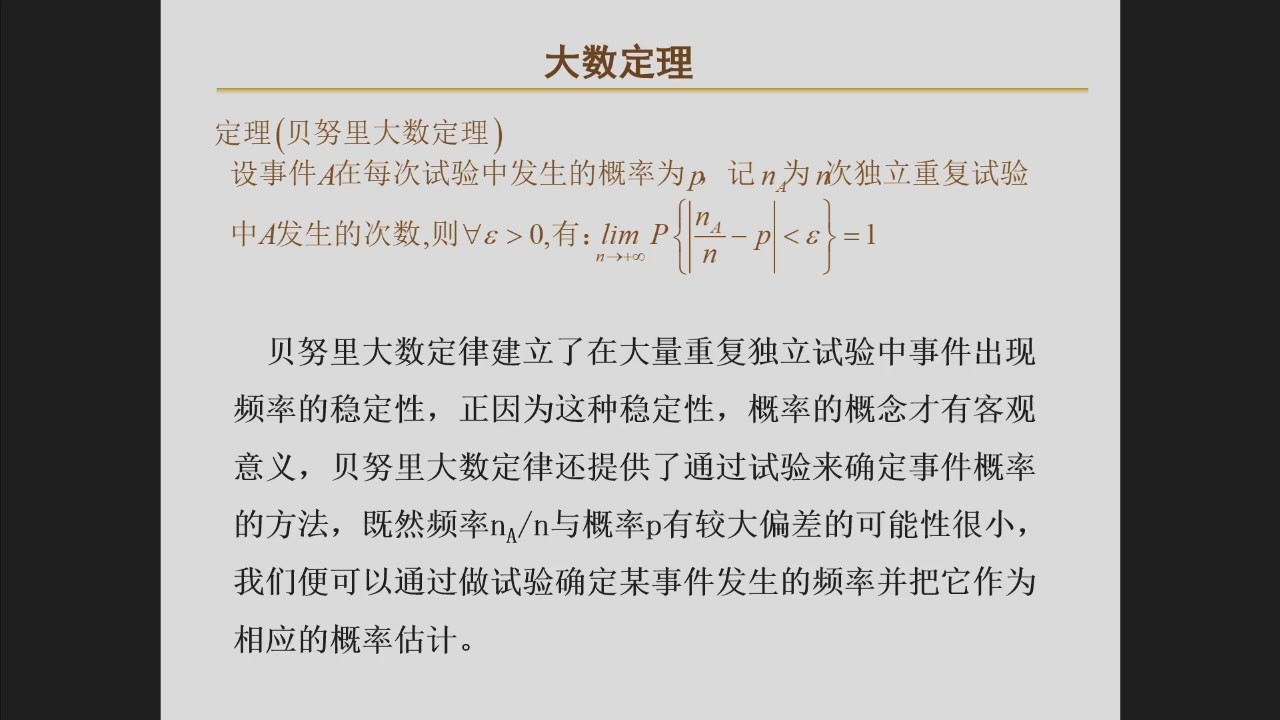
对于重复 Bernoulli 试验,事件发生频率会随着试验次数增加趋近于其真实概率,这解释了为什么可以用长期频率估计概率。
6.3 中心极限定理 Central Limit Theorem#
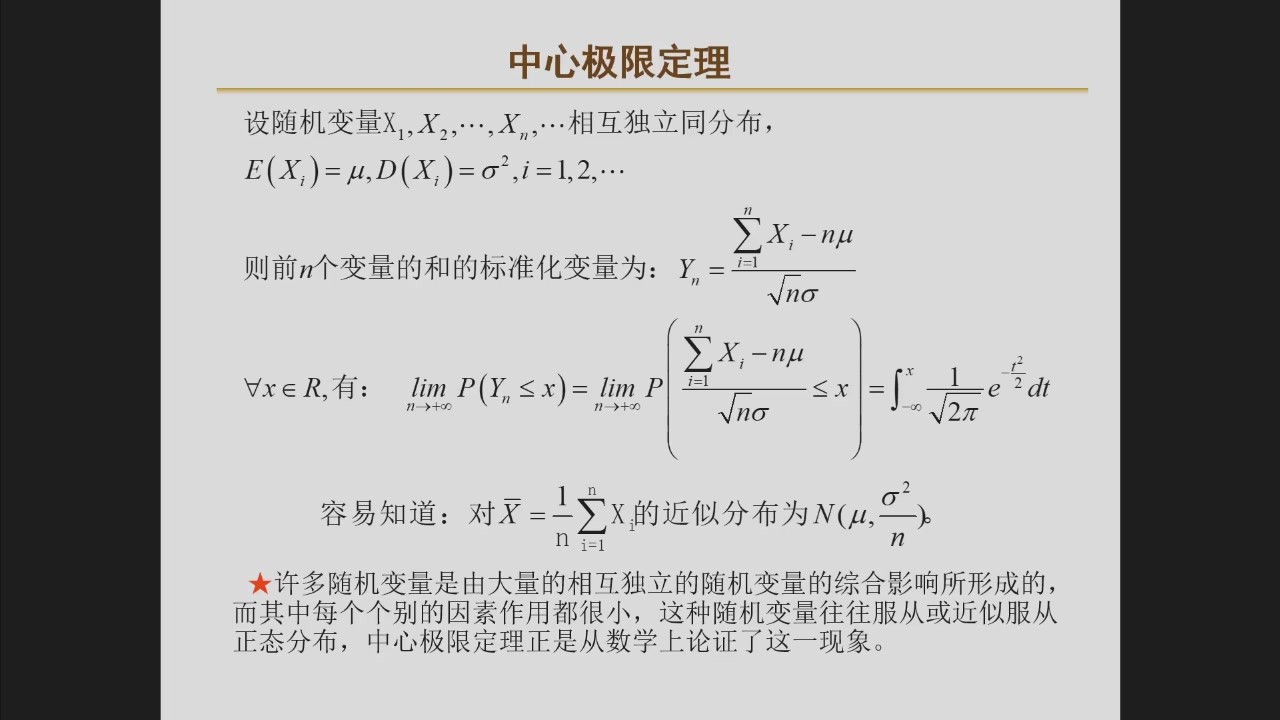
若:
X1,⋯,Xn相互独立同分布,且:
E(Xi)=μ,Var(Xi)=σ2<∞则标准化后的样本和:
σn∑i=1nXi−nμ在 n→∞ 时趋近标准正态分布:
σn∑i=1nXi−nμ⇒N(0,1)等价地:
σ/nXˉ−μ⇒N(0,1)也就是:
Xˉ≈N(μ,nσ2)当样本量足够大时,原总体即使不服从正态分布,样本均值的抽样分布也常可近似为正态。
TIP大数定律主要回答:
样本均值会不会靠近总体均值?
中心极限定理主要回答:
样本均值在大样本下呈现怎样的概率分布?
这是后续参数估计和统计检验的数学基础。
与时间序列的联系#
老师在这里提前联系到后面的时间序列:
- 大数定律和中心极限定理通常依赖独立性 / 弱依赖、稳定矩等条件;
- 许多经济时间序列存在趋势,均值或方差可能随时间变化;
- 因而第五章要专门讨论平稳性以及非平稳时间序列。
三、数理统计基础#
1. 总体、样本与简单随机样本#
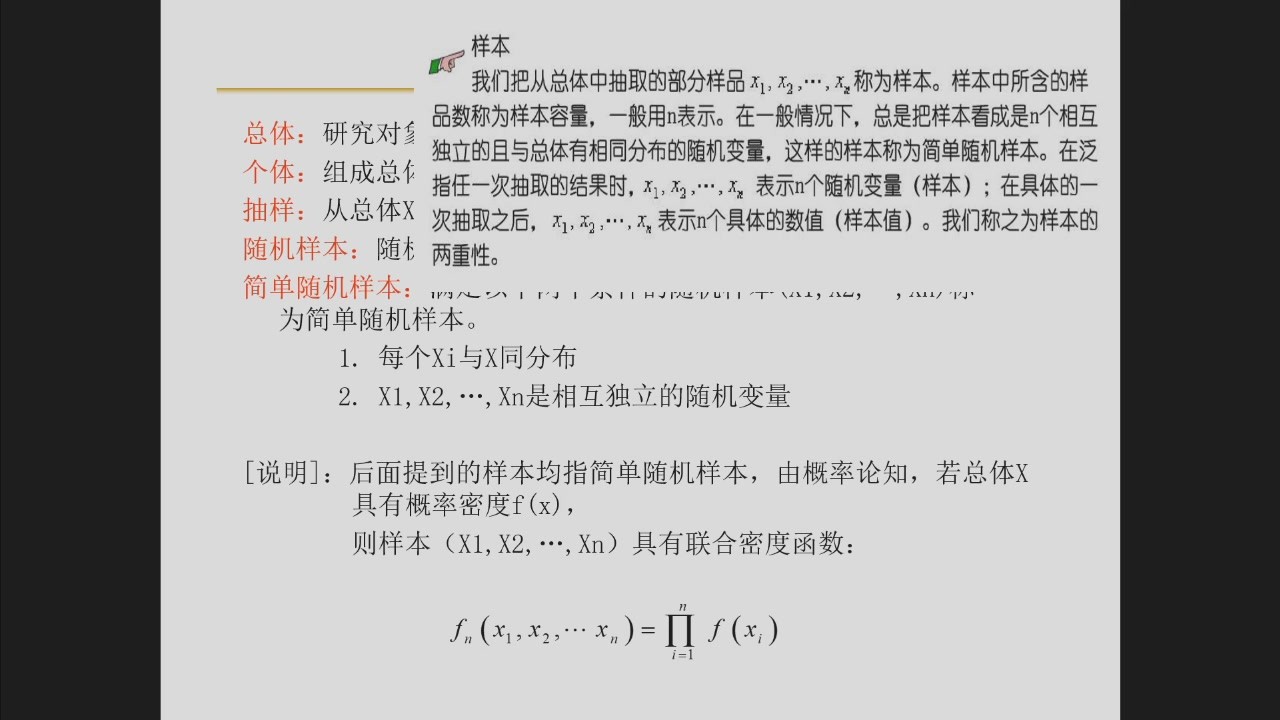
总体 Population#
研究对象全部个体构成总体。
总体可能:
老师举例:
- 某一时点全国大学生:有限总体;
- 持续营业的麦当劳未来顾客流:可视作无限总体;
- 持续运行的流水线产品:可视作无限总体。
样本 Sample#
从总体中抽取的:
X1,X2,⋯,Xn称为样本,n 为样本容量。
简单随机样本#
满足:
- 每个 Xi 与总体 X 同分布;
- X1,⋯,Xn 相互独立。
即:
X1,⋯,Xn∼i.i.d.F如果总体有密度 f(x),联合密度为:
f(x1,⋯,xn)=i=1∏nf(xi)样本的二重性#
抽样前:
Xi是随机变量。
抽样后,得到具体数值:
xi这就是一次已经实现的样本观测值。
为什么要抽样?#
目的:
用较小样本推断总体特征,显著降低调查成本。
老师举例:
- 总体可能有数千万人;
- 只随机抽取 1 万人,就可能较好地估计总体平均身高、平均体重等。
2. 统计量与常用样本统计量#
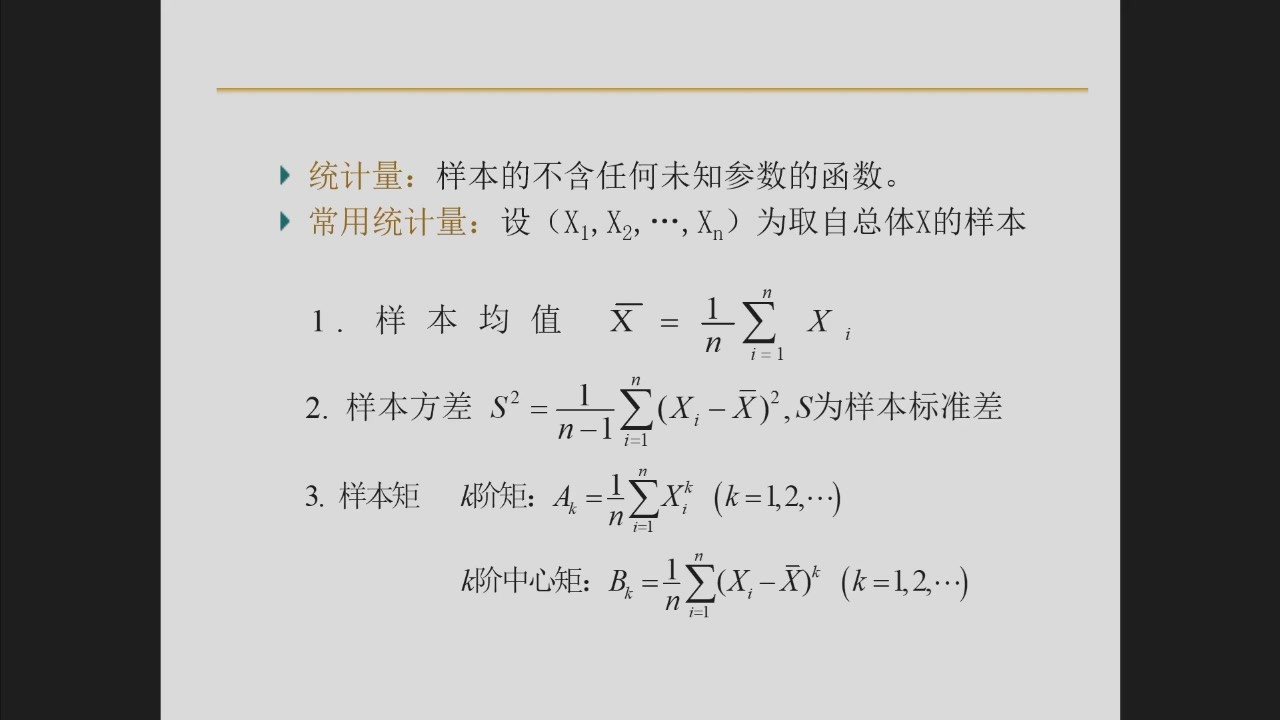
统计量 Statistic#
统计量是:
样本的函数,并且不含未知总体参数。
常用统计量:
样本均值#
Xˉ=n1i=1∑nXi样本方差#
S2=n−11i=1∑n(Xi−Xˉ)2其中 n−1 与无偏性有关。
样本标准差#
S=S2样本矩#
k 阶原点矩:
Ak=n1i=1∑nXikk 阶中心矩:
Bk=n1i=1∑n(Xi−Xˉ)k
3. 样本均值的抽样分布#
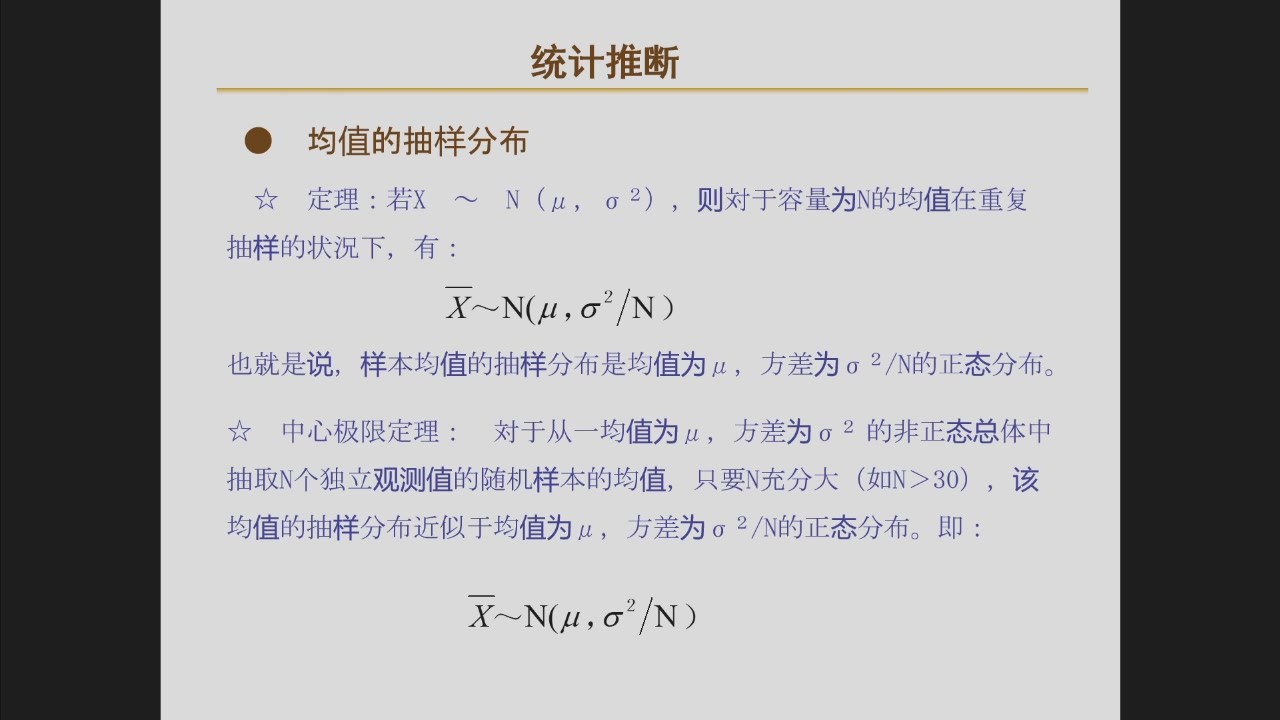
若总体:
X∼N(μ,σ2)则任意样本容量 n 下:
Xˉ∼N(μ,nσ2)即:
E(Xˉ)=μVar(Xˉ)=nσ2若总体并非正态,只要满足中心极限定理所需条件,当 n 足够大时:
Xˉ≈N(μ,nσ2)WARNINGPPT 使用了“如 N>30”这一经验规则。
n>30 只是课堂常用的粗略经验,并非中心极限定理的严格统一阈值。实际近似质量还取决于总体分布的偏度、厚尾程度等。
4. 参数的点估计#
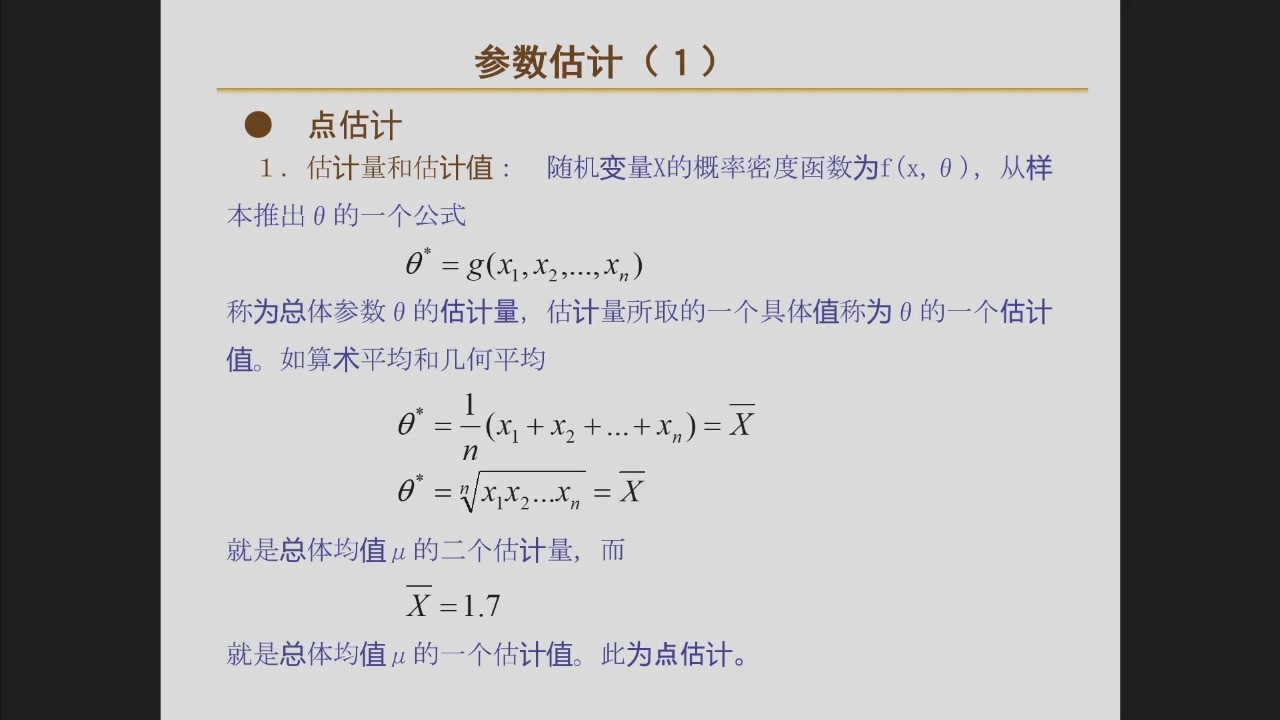
假设总体分布中含未知参数 θ。
从样本构造统计量:
θ^=g(X1,X2,⋯,Xn)称为 θ 的估计量 estimator。
抽到具体样本后得到:
θ^=g(x1,x2,⋯,xn)其具体数值称为估计值 estimate。
课堂例子:估计总体均值#
可以构造:
算术平均#
μ^1=Xˉ=n1i=1∑nXi几何平均#
μ^2=nX1X2⋯Xn两者都可以形成统计量,但作为“总体均值”的估计量,其统计性质并不相同。
极大似然估计 MLE#
老师简要提到:
- 一般点估计可以直接构造统计量;
- 极大似然法需要先给定总体的概率分布族 f(x;θ);
- 再根据样本选择使似然函数最大的参数值。
后续多元回归章节会正式学习。
5. 点估计量的优良性质#
5.1 小样本性质#
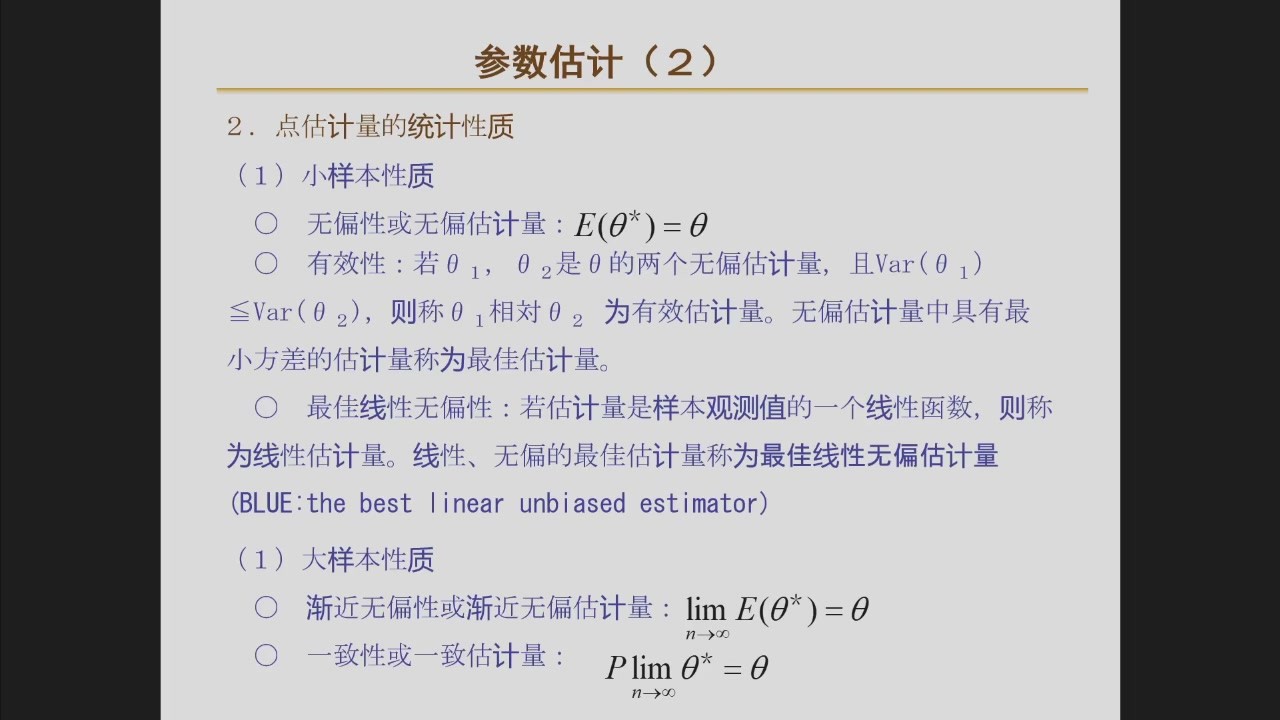
无偏性#
E(θ^)=θ含义:
重复抽样时,估计量的平均值等于真实参数。
有效性#
若 θ^1,θ^2 都是 θ 的无偏估计量,且:
Var(θ^1)≤Var(θ^2)则 θ^1 更有效。
直观上:
两个估计量都“平均不偏”,方差更小的那个更稳定。
BLUE#
如果估计量:
- 是样本观测值的线性函数;
- 无偏;
- 在线性无偏估计量中具有最小方差;
则称为:
Best Linear Unbiased Estimator,最佳线性无偏估计量(BLUE)。
后续 Gauss-Markov 定理会把这个概念用于 OLS。
5.2 大样本性质#
渐近无偏性#
n→∞limE(θ^n)=θ一致性 Consistency#
θ^npθ即:
plimn→∞θ^n=θ一致性强调:
样本量越来越大时,估计量越来越集中到真实参数附近。
6. 区间估计#
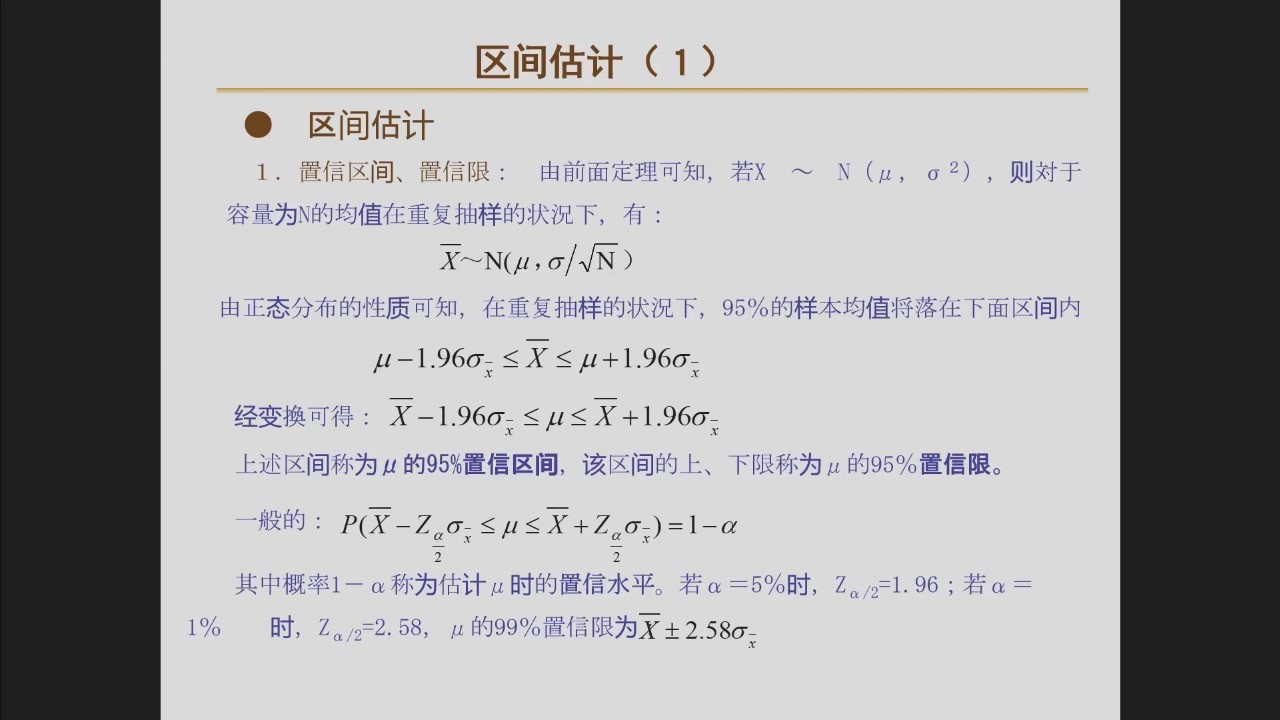
若:
X∼N(μ,σ2)且 σ 已知,则:
Xˉ∼N(μ,nσ2)因此:
Z=σ/nXˉ−μ∼N(0,1)给定显著性水平 α:
P(−zα/2≤σ/nXˉ−μ≤zα/2)=1−α整理:
P(Xˉ−zα/2nσ≤μ≤Xˉ+zα/2nσ)=1−α所以 μ 的 (1−α) 置信区间为:
Xˉ±zα/2nσ95% 置信区间#
z0.025=1.96因此:
Xˉ±1.96nσ99% 置信区间#
z0.005≈2.58因此:
Xˉ±2.58nσTIP置信水平 1−α 越高,区间通常越宽。
样本量 n 越大:
nσ越小,因此区间越窄,估计精度提高。
7. 假设检验#
7.1 基本思想:小概率事件#
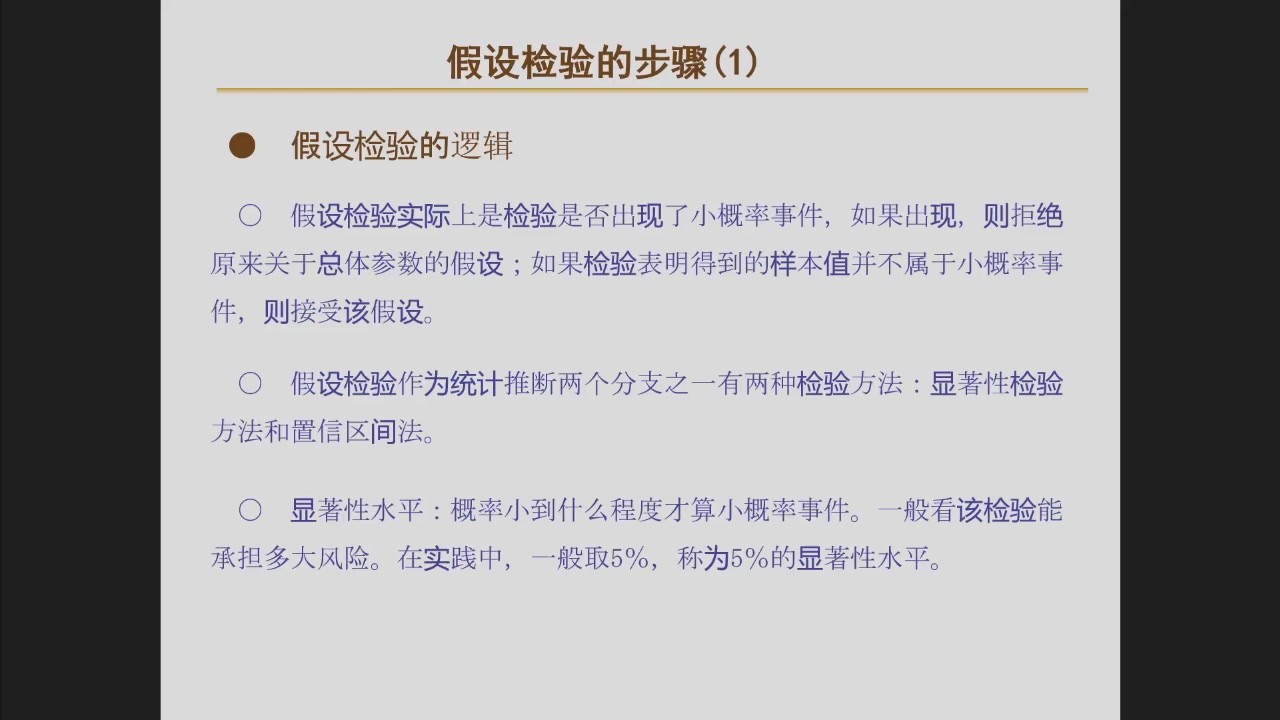
假设检验基于:
在原假设成立的条件下,小概率事件在一次抽样中通常不应出现。
若实际样本落入原假设下非常罕见的区域,就有理由拒绝原假设。
老师把它类比为反证法。
常用显著性水平:
α=5%也常用:
α=1%,10%
7.2 老师要求记牢的“三句话”#
老师明确强调,做任何假设检验都先回答:
- 零假设 H0 是什么?
- 统计量是什么?
- 结论是什么?
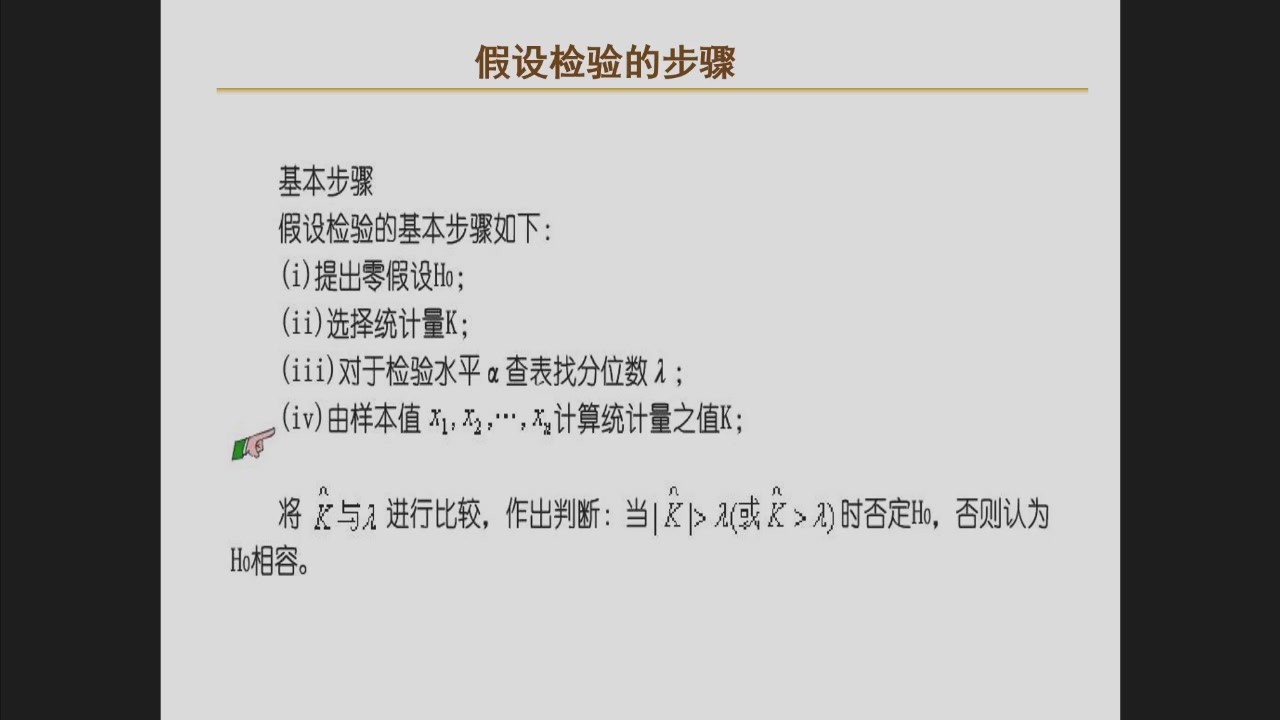
完整步骤:
- 提出零假设 H0 和备择假设 H1;
- 构造在 H0 下分布已知的检验统计量;
- 给定显著性水平 α;
- 确定临界值 / 拒绝域;
- 用样本计算统计量;
- 判断是否拒绝 H0;
- 写出经济学或统计学结论。
7.3 两种判别方法#
方法一:临界值法#
将统计量与临界值比较。
双侧检验例:
∣Z∣>zα/2则拒绝 H0。
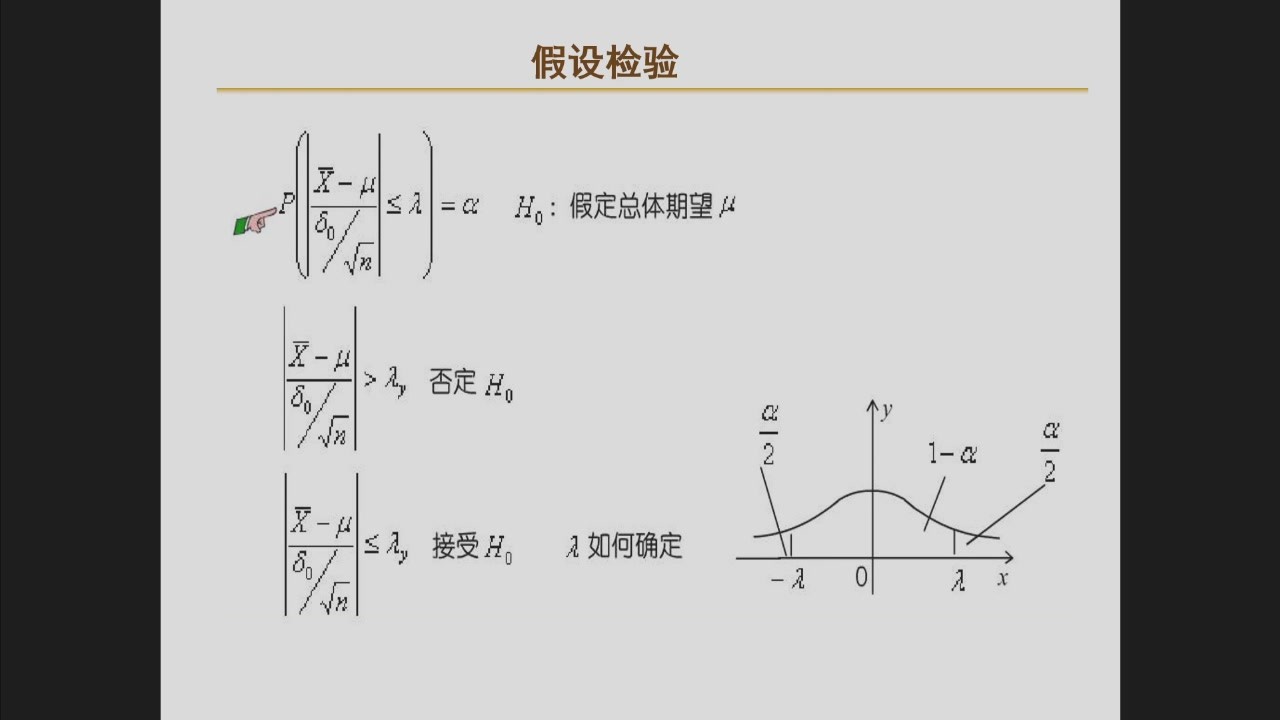
老师强调:
考试重点使用临界值法。
方法二:p-value 法#
计算:
在 H0 成立时,得到当前样本结果或更极端结果的概率。
若:
p<α则拒绝 H0。
老师指出:
实际研究和论文中更常使用 p-value 法。
WARNING统计学上更规范的表述是:
- “拒绝 H0”
- “未能拒绝 H0”
通常避免把“未拒绝”直接说成“证明 H0 正确”。
8. 两类错误#
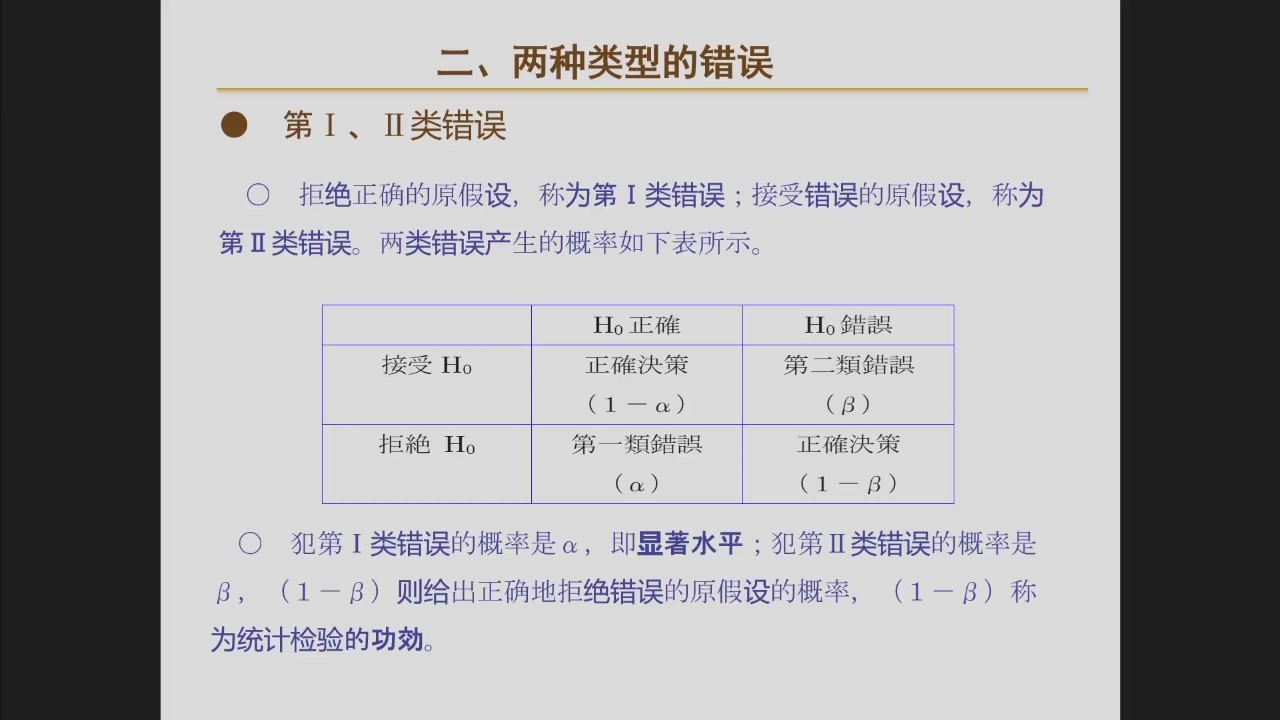
第一类错误 Type I Error#
H0 实际为真,却被拒绝。
P(Type I Error)=α课堂概括:
以真为假。
第二类错误 Type II Error#
H0 实际为假,却未被拒绝。
P(Type II Error)=β课堂概括:
以假为真。
检验功效 Power#
1−β表示:
当 H0 的确为假时,正确拒绝 H0 的概率。
四、第二章 §2.1 回归分析概述#
TIPPPT 与第五版教材的章节编号有一处版本差异#
课堂 PPT 的章目录仍写为:
- §2.1 回归分析概述
- §2.2 参数估计
- §2.3 统计检验
- §2.4 预测
- §2.5 实例:时间序列问题
你提供的《计量经济学(第五版)》目录则为:
- §2.1 回归分析概述
- §2.2 一元线性回归模型的参数估计
- §2.3 基本假设与 OLS 估计量的统计性质
- §2.4 一元线性回归模型的统计检验
- §2.5 一元线性回归分析的应用:预测问题
- §2.6 建模实例
本节实际讲授内容与第五版教材 §2.1 高度对应。
1. 变量之间的两类关系#
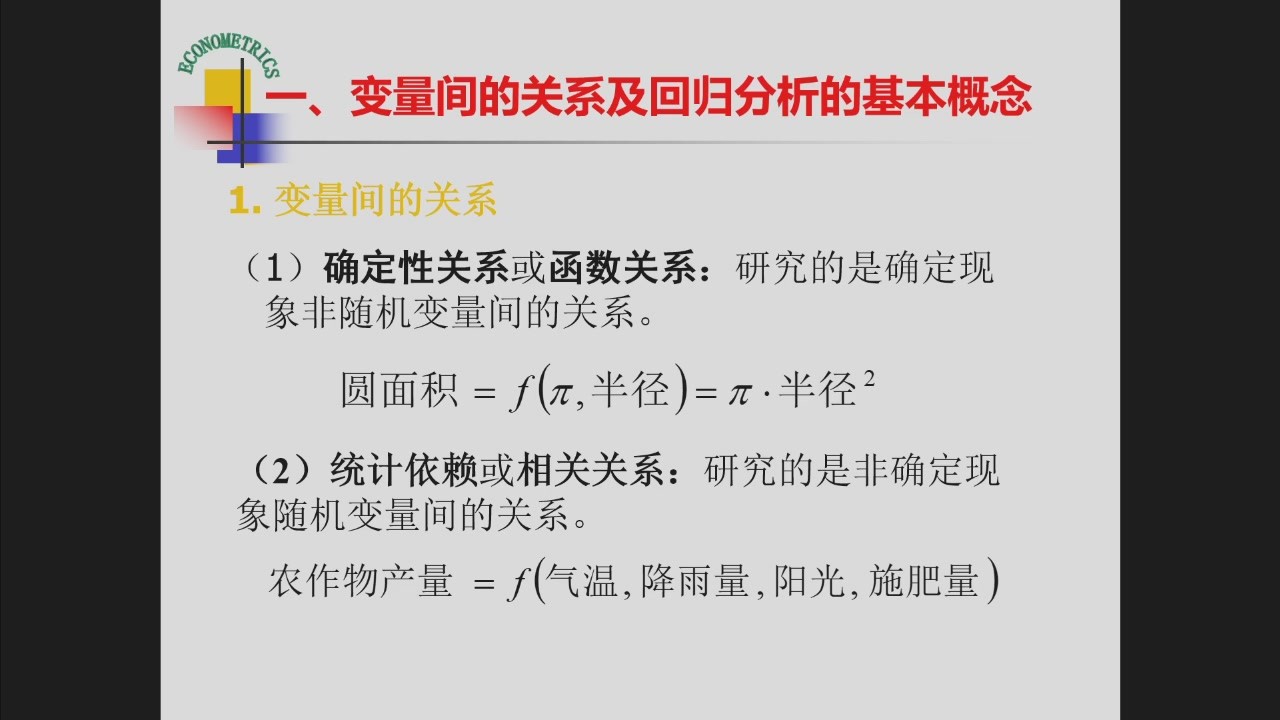
1.1 确定性关系 / 函数关系#
变量之间存在完全确定的函数映射。
例:圆面积与半径#
S=πr2一旦 r 确定,S 唯一确定。
1.2 统计依赖关系#
一个变量确定后,另一个变量仍然存在随机波动。
例:农作物产量#
产量可能受到:
影响。
即使把温度、降水、日照、施肥等因素给定,也很难唯一确定下一年的粮食产量。
因此:
Y=f(X1,X2,⋯)+随机因素更符合经济现象。
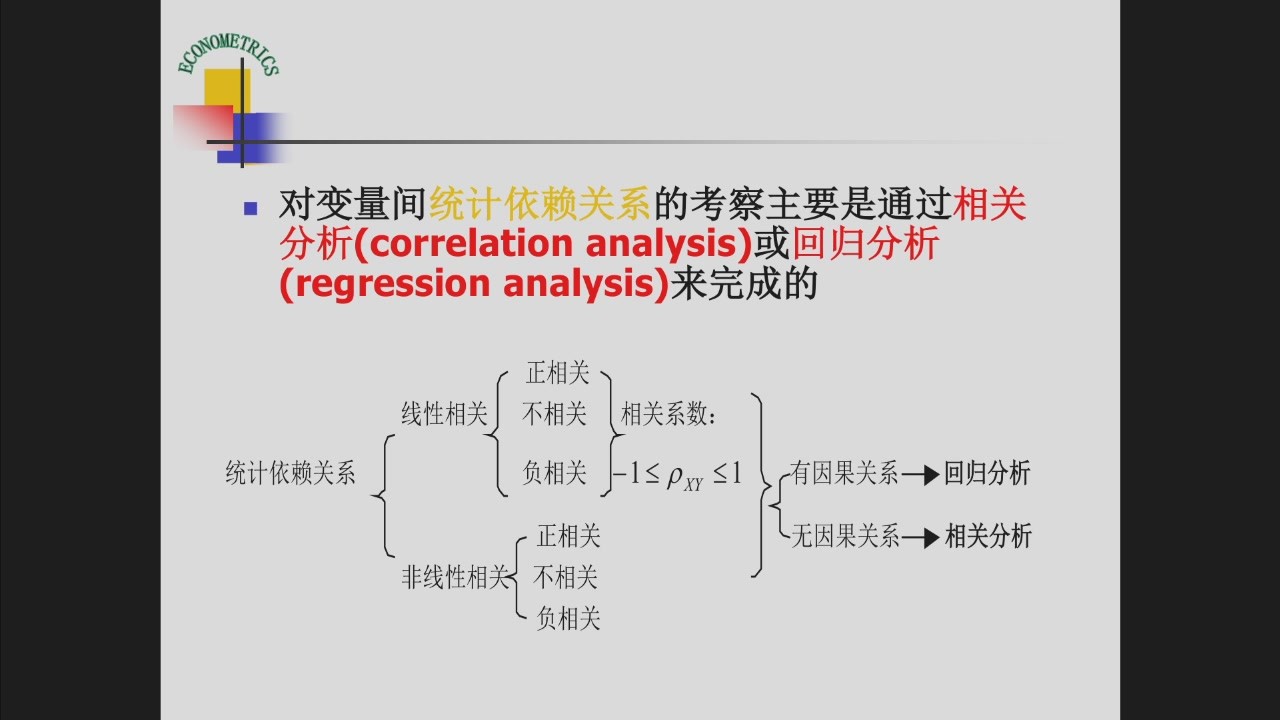
2. 相关关系的分类#
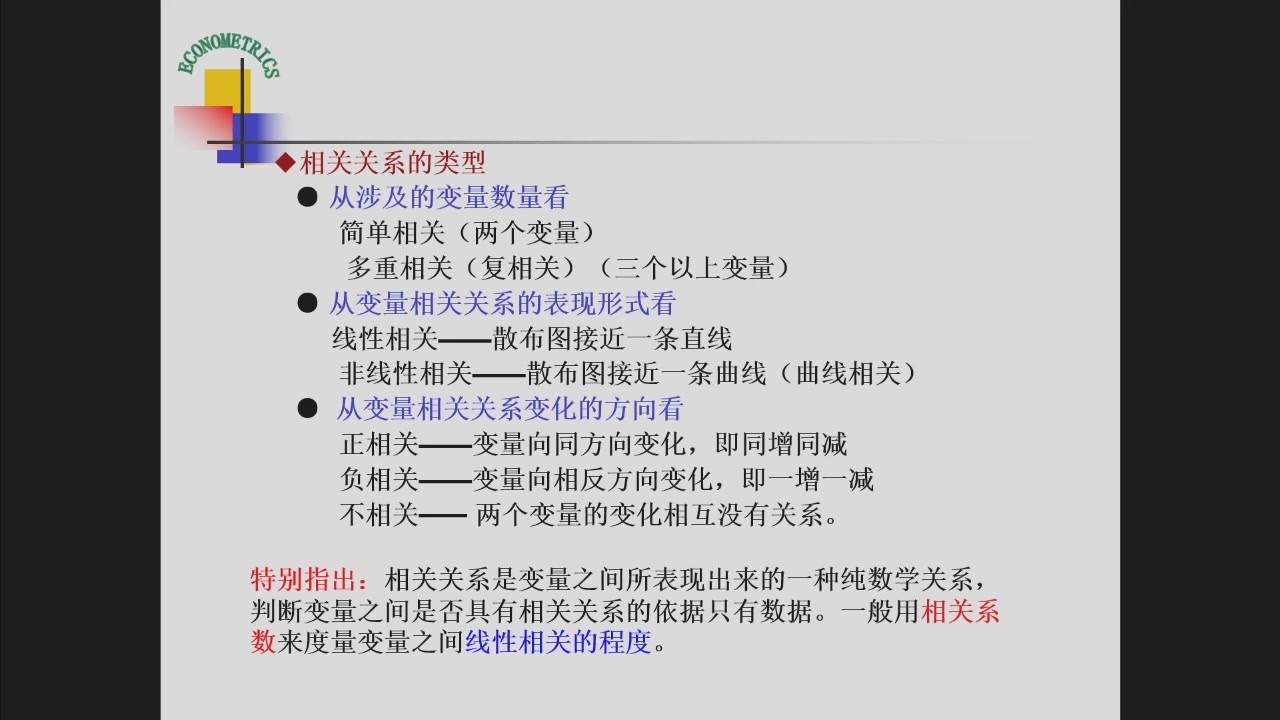
按变量个数#
- 简单相关:两个变量
- 多重相关 / 复相关:三个及以上变量
按方向#
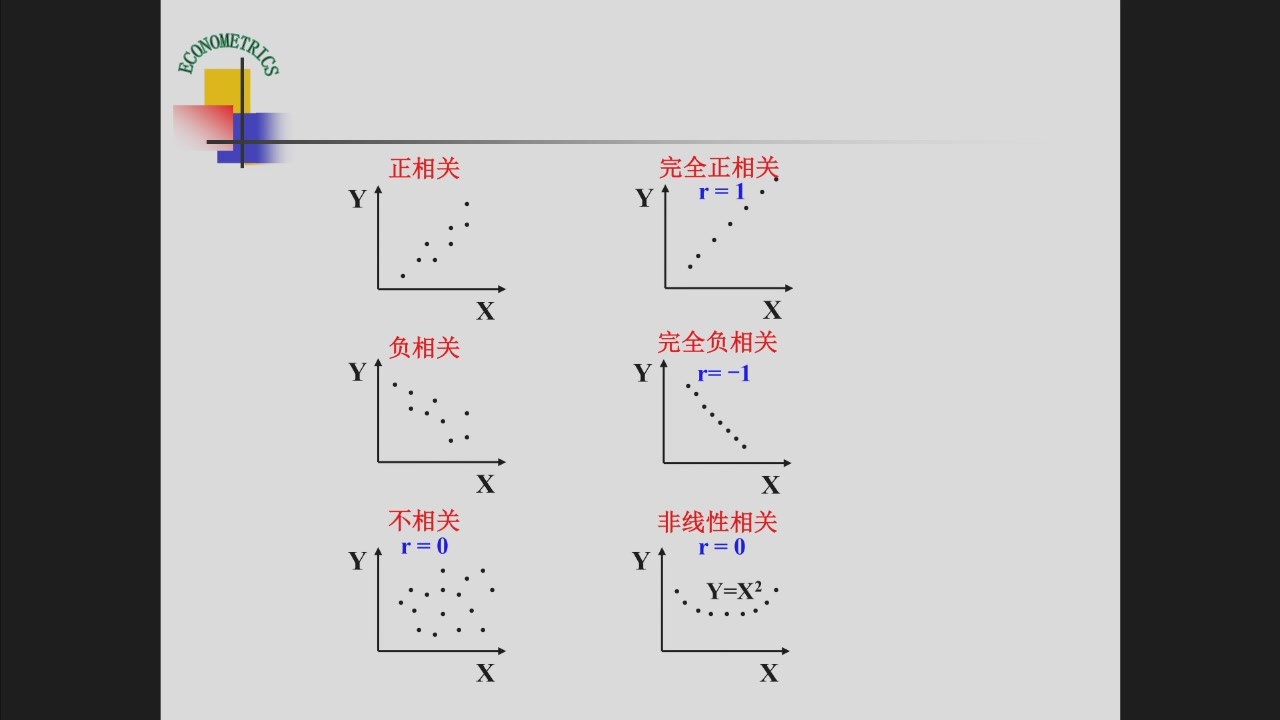
WARNING图中“非线性相关”即使相关系数可能接近 0,变量之间仍然可以存在非常强的系统关系。
因此:
相关系数主要刻画线性相关程度。
3. 相关分析与回归分析#
3.1 样本相关系数#
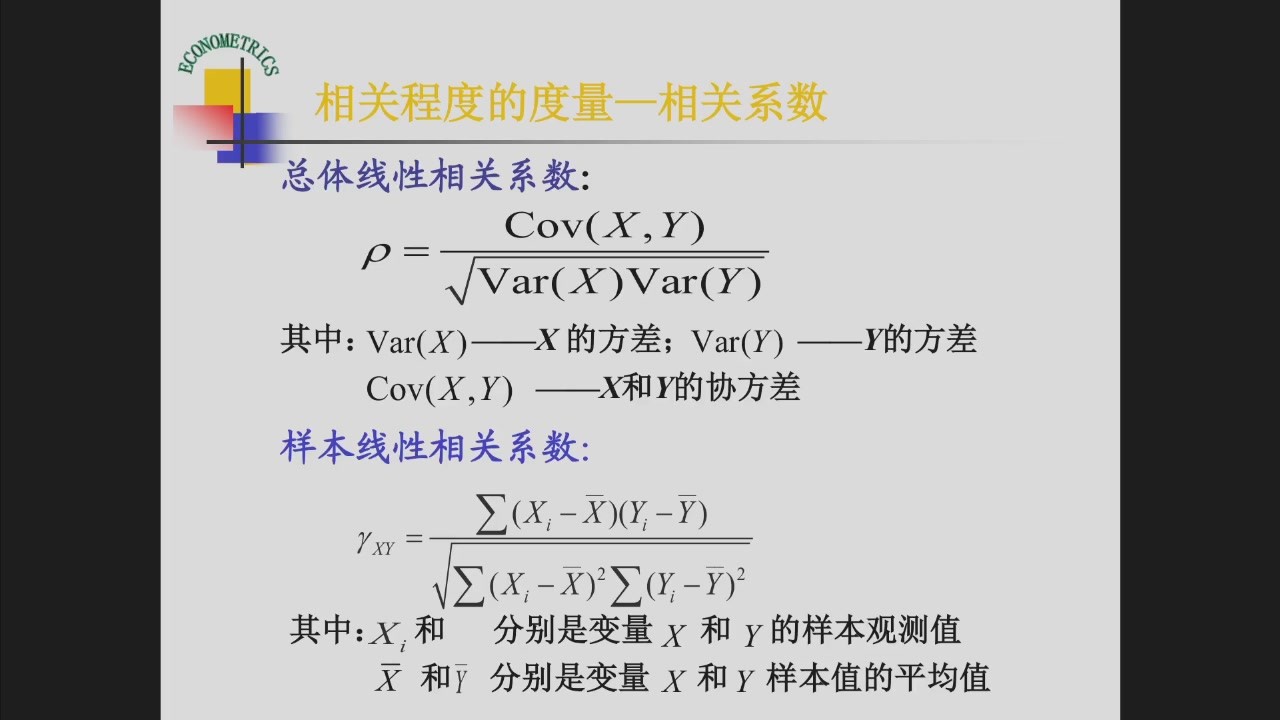
样本线性相关系数:
rXY=∑i=1n(Xi−Xˉ)2∑i=1n(Yi−Yˉ)2∑i=1n(Xi−Xˉ)(Yi−Yˉ)3.2 相关分析#
关注:
两个变量在统计上是否存在联系,以及线性联系有多强。
X 和 Y 的地位通常是对称的。
3.3 回归分析#
课堂中的表述重点在于:
研究具有明确解释方向的统计依赖关系,即解释变量变化时,被解释变量的条件平均水平如何变化。
课堂例子:鞋码与知识水平#
儿童长大时:
所以二者可能具有正相关关系。
但鞋码变大并不会直接导致知识增加。
共同原因更可能是:
因此:
相关关系本身不能自动推出因果关系。
消费例子#
可支配收入上升通常会带来消费支出增加。
课堂将:
- 可支配收入 X 作为解释变量;
- 消费支出 Y 作为被解释变量。
WARNING老师在课堂上将回归分析与“因果关系”紧密联系。
进一步做实证研究时需要多加一层判断:
一条回归关系能否解释为因果效应,还取决于外生性、遗漏变量、反向因果、研究设计等识别条件。
单纯跑出回归系数,并不足以单独证明因果关系。
4. 家庭收入—消费支出案例#
这一部分是本节进入回归分析的核心案例,也对应第五版教材 §2.1。
研究对象:
某社区家庭每月可支配收入 X 与每月消费支出 Y 的关系。
课堂设定把社区内家庭视为研究总体。
调查每户家庭:
得到原始成对数据:
(Xi,Yi)按收入分组#
老师按照教材中的收入水平进行分组:
800, 1100, 1400, 1700, 2000, 2300, 2600, 2900, 3200, 3500组距基本为 300 元。
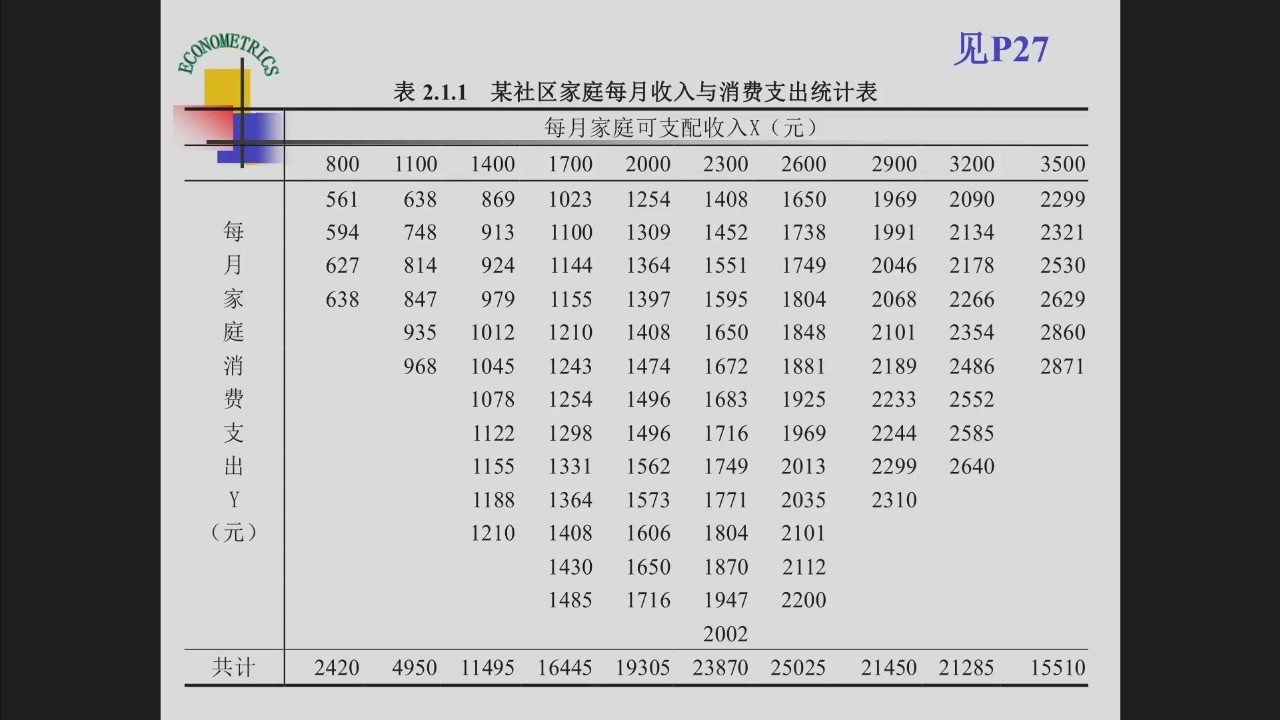
老师重点展开:X=800 这一组#
该组有 4 户家庭,消费支出分别为:
561, 594, 627, 638虽然收入组相同,消费支出仍有差异。
这说明:
给定 X=800 后,Y 仍是随机变量。
同理:
- 给定 X=1100,Y 仍有多个可能值;
- 给定 X=1400,Y 仍有多个可能值;
- ……
- 给定任意 X=xi,对应的 Y 都形成一个条件分布。
5. 条件分布与条件期望#
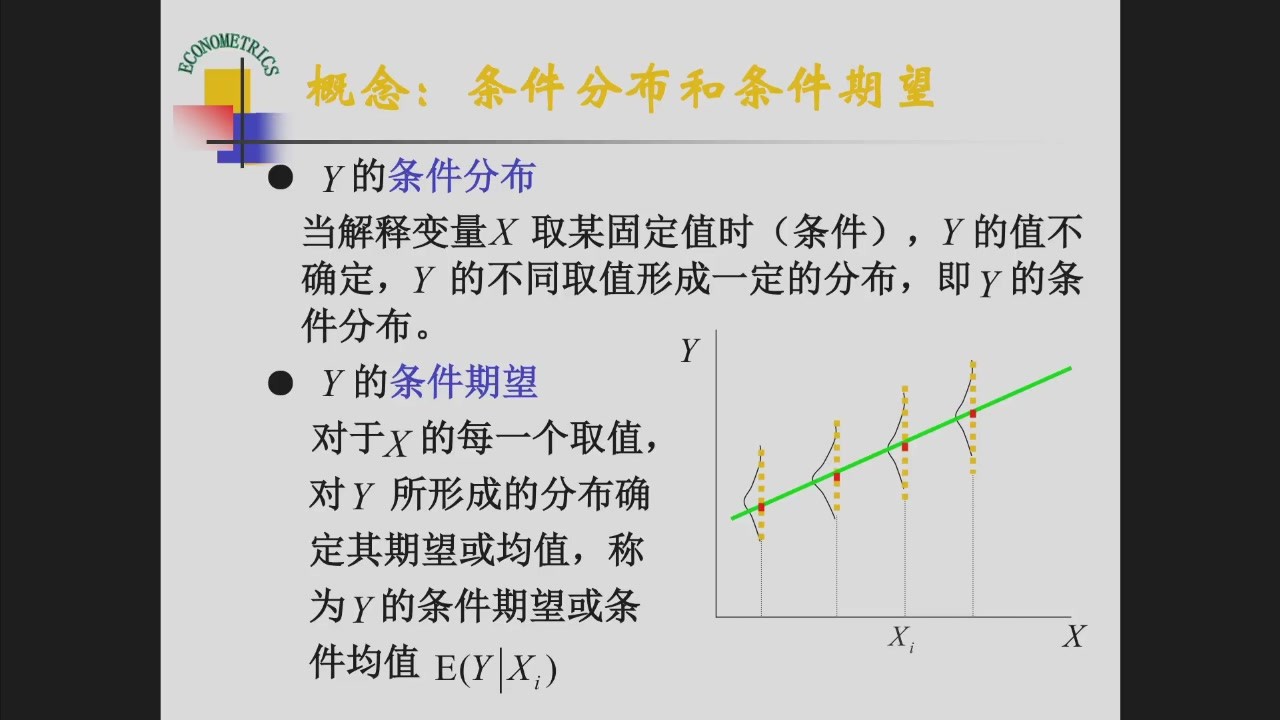
条件分布#
固定解释变量:
X=x后,被解释变量仍具有概率分布:
Y∣X=x称为 Y 在给定 X=x 条件下的条件分布。
条件期望#
对每一个 X=x,都有:
E(Y∣X=x)表示:
给定收入水平 x 时,家庭消费支出的平均水平。
教材案例各收入组的条件均值为:
| 每月可支配收入 X | 组内户数 | 条件均值 E(Y∣X) |
|---|
| 800 | 4 | 605 |
| 1100 | 6 | 825 |
| 1400 | 11 | 1045 |
| 1700 | 13 | 1265 |
| 2000 | 13 | 1485 |
| 2300 | 14 | 1705 |
| 2600 | 13 | 1925 |
| 2900 | 10 | 2145 |
| 3200 | 9 | 2365 |
| 3500 | 6 | 2585 |
例如:
E(Y∣X=800)=4561+594+627+638=605这里要抓住:
同一个 X 下,具体 Y 是随机的;
但该条件分布的平均值 E(Y∣X) 是确定的。
6. 总体回归线与总体回归函数 PRF#
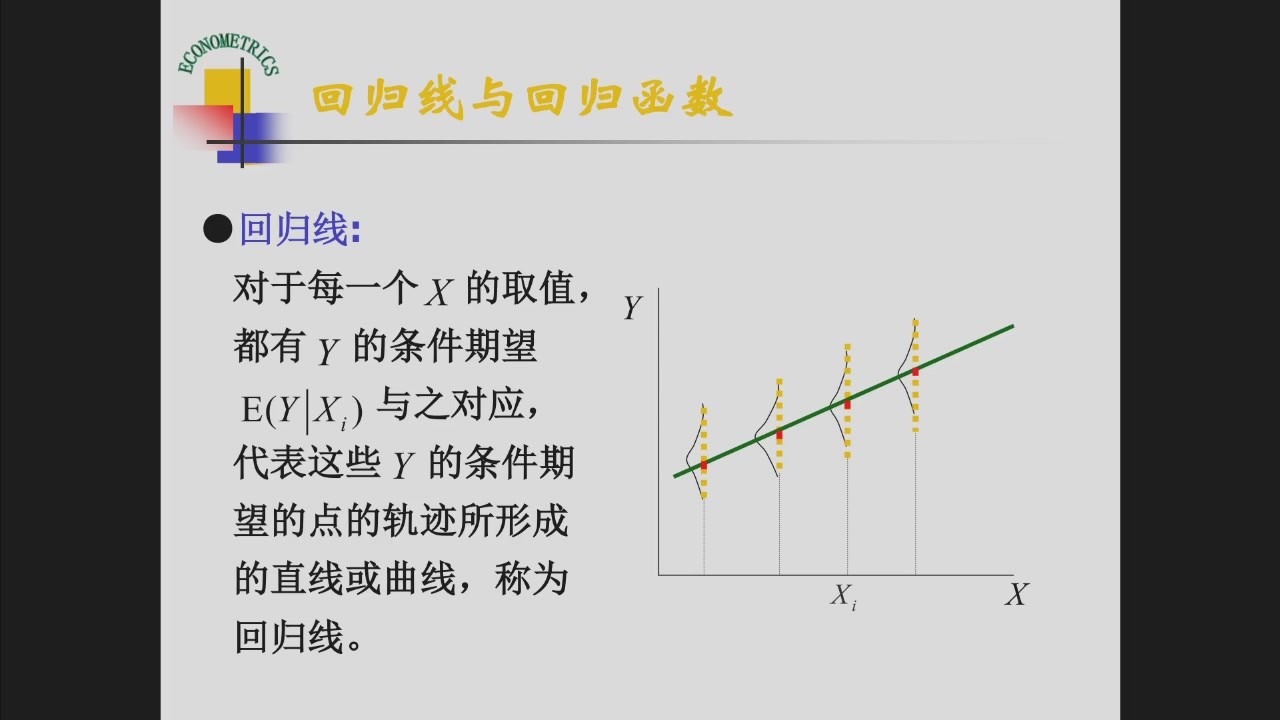
对不同的 X:
x1,x2,⋯分别求:
E(Y∣X=x1),E(Y∣X=x2),⋯把这些条件期望点连起来,就得到:
总体回归线 Population Regression Line
更一般地,它可能是一条曲线,因此也称总体回归曲线。
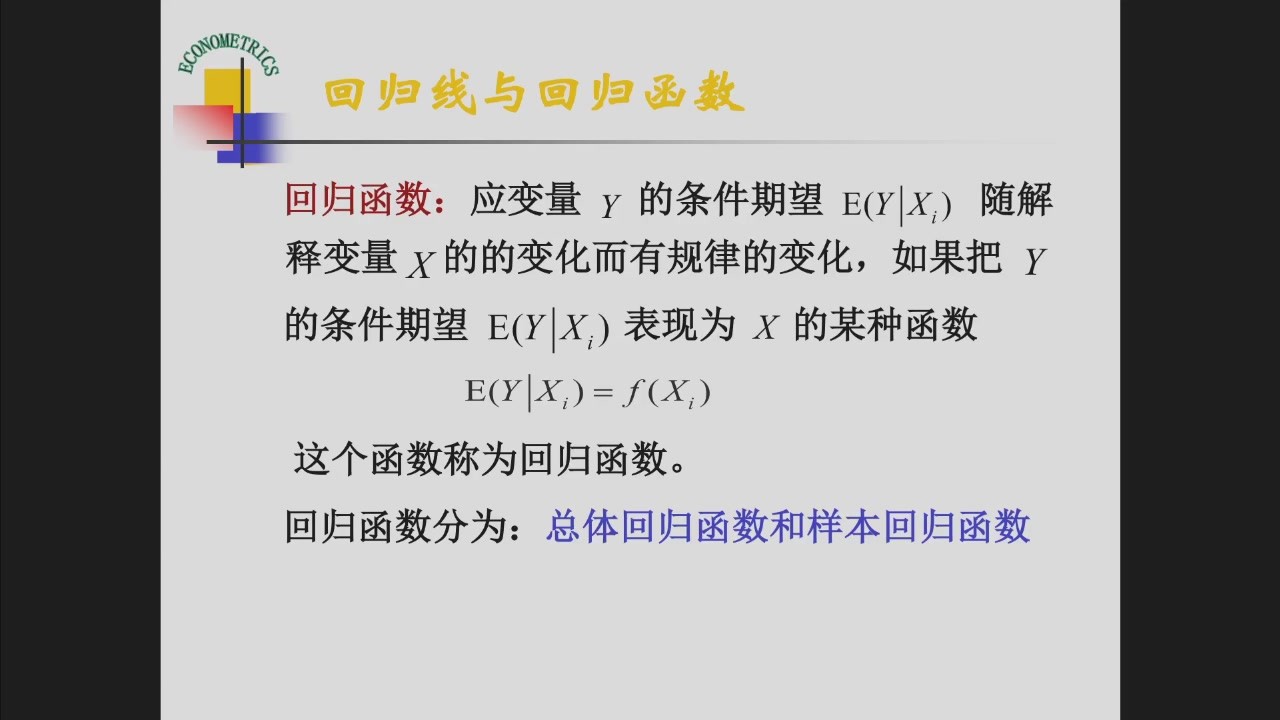
对应函数:
E(Y∣X)=f(X)称为:
总体回归函数 Population Regression Function, PRF
它描述:
被解释变量 Y 的总体条件平均水平如何随解释变量 X 系统变化。
线性总体回归函数#
若进一步假定:
f(X)为线性函数,则:
E(Y∣X)=β0+β1X其中:
- β0:截距;
- β1:斜率 / 回归系数。
在消费模型中:
β1表示可支配收入增加 1 单位时,平均消费支出变化多少。
TIP这一点是理解回归分析最关键的地方:
回归线研究的是:
E(Y∣X)即条件平均关系。
它没有要求每一个观测点都严格落在一条直线上。
本节截止位置#
教材 §2.1 后续还包括:
但老师本节课在讲完线性 PRF:
E(Y∣X)=β0+β1X后结束,明确说明:
样本回归函数下一节课再讲。
因此本份 Lesson 2 笔记也停在这里。
五、本节易错点与知识链#
1. 最容易混淆的几个概念#
随机变量 vs 一个具体数值#
- X:抽样前的随机变量;
- x:随机变量实现后的一个具体值。
总体参数 vs 估计量 vs 估计值#
- θ:未知总体参数;
- θ^:由样本随机变量构成的估计量;
- 得到具体样本后,θ^ 计算出来的数字是估计值。
方差 vs 标准差#
Var(X)=σ2SD(X)=σ
独立 vs 不相关#
独立通常可以推出不相关:
X⊥Y⇒Cov(X,Y)=0反过来一般不能成立。
相关系数为 0 vs 没有关系#
ρ=0表示没有线性相关。
变量仍可能存在很强的非线性关系。
相关关系 vs 因果关系#
相关只说明共同变化。
因果解释还需要额外识别条件。
大数定律 vs 中心极限定理#
大数定律:
Xˉpμ告诉我们“样本均值会靠近谁”。
中心极限定理:
σ/nXˉ−μ⇒N(0,1)告诉我们“样本均值怎样随机波动”。
条件分布 vs 条件期望#
给定:
X=x后,Y 仍有一整个条件分布。
其中的平均值:
E(Y∣X=x)只是这个分布的一个数字特征。
回归线#
总体回归线由:
(x,E(Y∣X=x))这些点形成。
一句话:
回归分析的核心对象是条件期望函数。
资料来源#
- 孔伟杰:《计量经济学》课堂 PPT 与课堂讲授,2026-09-20。
- 李子奈、潘文卿:《计量经济学(第五版)》,高等教育出版社,2020。重点对应教材第一章建模部分与第二章 §2.1“回归分析概述”。
