课程说明与考核提醒#
- 记录日期:2026-10-14;对应课堂:2026-10-13,第11—13节;任课教师:孔伟杰。
- 涉及教材:李子奈、潘文卿《计量经济学》(第五版),第2章:§2.2 拟合优度(后半部分)→ §2.4 一元线性回归模型的统计检验 → §2.5 一元线性回归分析的应用:预测问题。课件中的假设检验推导还用到 §2.3 基本假设与OLS估计量的统计性质。
- 作业 / 测试 / 考试说明:现有PPT未出现可确认的具体作业题号、截止时间、测试安排或计分规则。所提供的录音DOCX可提取内容主要是时间戳与课堂画面,缺少可读取的口头转写,因此无法据此核实老师有没有口头布置作业。下面不会把自主练习冒充为老师指定作业。
- 材料核对:课件第1—29页为知识内容,第30页为教室电脑提示,第31—33页为电脑画面;例题数值以表格原始数据和软件输出为准。部分课件文字与教材中的计算采用不同精度,相关位置已注明。
这一节课的核心逻辑是:先判断模型对样本解释得好不好,再判断估计出的系数是否显著,最后量化参数和预测结果的不确定性。
- 拟合优度(R2):样本点离回归线有多近?Y 的样本波动有多大比例被线性回归解释?
- 显著性检验(t 检验与 p 值):样本得到的斜率可能来自抽样波动吗?有没有足够证据表明总体斜率不等于零?
- 参数置信区间:仅给出一个估计值还不够,总体参数可能处在哪个范围?
- 统计预测:给定新的收入 X0,预测平均消费或某个家庭的消费,两种区间为什么宽度不同?
一条主线:
样本回归直线 Y^i=β^0+β^1Xi → R2 衡量拟合 → se(β^j) 衡量估计精度 → t / p 判断显著性 → 参数置信区间 → 均值与个值预测区间。
一、拟合优度与可决系数(教材 §2.2)#
1. 为什么估计完回归直线后,还要衡量拟合优度?#
已知一元线性回归模型:
Yi=β0+β1Xi+μi用普通最小二乘法(OLS)得到样本回归函数:
Y^i=β^0+β^1Xi,ei=Yi−Y^i其中:
- Yi:真实观测值;Y^i:回归线给出的拟合值;ei:残差。
- OLS 选择 β^0,β^1,使残差平方和 ∑ei2 最小。
- 不同样本、不同变量关系都可能得到一条回归线;还要评价这条线在给定样本中的拟合程度。
令 Yˉ 为样本均值,yi=Yi−Yˉ,y^i=Y^i−Yˉ。则:
总离差Yi−Yˉ=回归解释部分(Y^i−Yˉ)+残差部分(Yi−Y^i)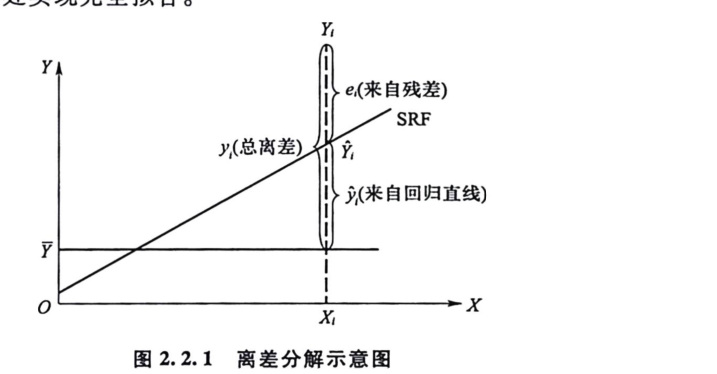
直观地看,在同一个 Xi 处,Yi 到样本均值 Yˉ 的竖直距离,可以拆成“回归拟合值到均值的距离”与“观测值到拟合值的距离”。
两边平方再加总:
∑(Yi−Yˉ)2=∑(Y^i−Yˉ)2+∑ei2+2∑(Y^i−Yˉ)ei对于包含截距项的OLS回归,正规方程保证:
∑ei=0,∑Xiei=0由于 Y^i−Yˉ=β^1(Xi−Xˉ),交叉项为零:
∑(Y^i−Yˉ)ei=β^1[∑Xiei−Xˉ∑ei]=0因此:
TSS=ESS+RSS
| 缩写 | 名称 | 公式 | 直观含义 |
|---|
| TSS | Total Sum of Squares,总离差平方和 | ∑(Yi−Yˉ)2 | Y 原本有多少波动 |
| ESS | Explained Sum of Squares,回归平方和 | ∑(Y^i−Yˉ)2 | 被回归线解释的波动 |
| RSS | Residual Sum of Squares,残差平方和 | ∑(Yi−Y^i)2 | 回归后仍未解释的波动 |
TIP为什么不能直接比较两个模型的 RSS 大小?
RSS 受 Y 的量纲和原始波动大小影响。将它与同一样本、同一个被解释变量的 TSS 相比,能获得更便于解释的相对拟合指标。改变被解释变量或样本时,比较 R2 也需要谨慎。
3. 可决系数 R2#
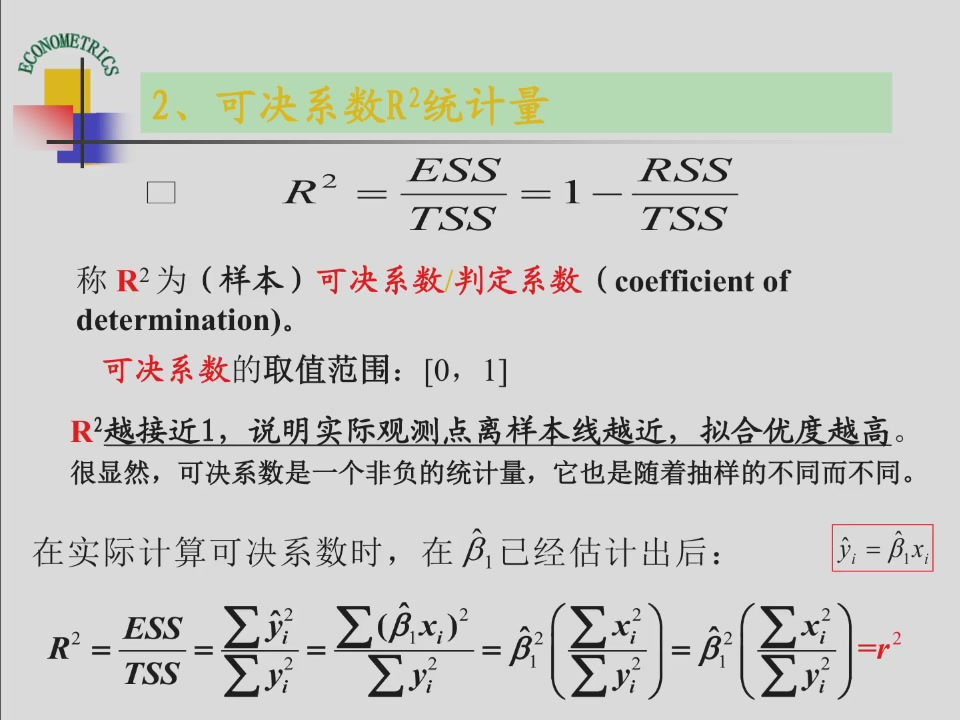
R2=TSSESS=1−TSSRSS在含截距项的OLS模型且 TSS>0 时:
- 0≤R2≤1;R2=1 为样本完全拟合;越接近 1,样本拟合通常越紧密。
- 例如 R2=0.80,表示样本中 Y 围绕均值的平方离差约有80%被该回归解释。
- R2 是样本统计量,换一个样本可能得到不同结果。
需要区分:R2 高不能单独证明因果关系成立,也无法保证模型设定正确、预测一定准确。
4. R2 与样本相关系数 r 的关系#
一元含截距项OLS中,令 xi=Xi−Xˉ,yi=Yi−Yˉ,有:
β^1=∑xi2∑xiyi,y^i=β^1xi于是:
R2=∑yi2∑y^i2=∑yi2β^12∑xi2=(∑xi2)(∑yi2)(∑xiyi)2=rXY2其中:
rXY=∑xi2∑yi2∑xiyi注意 R2 丢失了方向信息:正相关或负相关都可能得到较大的 R2;关系方向要看 β^1 的正负。
WARNING课件公式 R2=r2 的适用条件是一元、包含截距项、用OLS估计。在多元回归、无截距回归或其他估计方法中,不能不加条件直接套用。
二、统计推断的准备:模型假设与抽样分布(教材 §2.3、§2.4)#
1. 为什么 β^ 的数值还不足以判断显著性?#
例如某次样本估计得到 β^1=0.67,这只能说明这组样本中的回归斜率是 0.67。换样本后,斜率可能变化。为了判断总体中的 β1 是否可能为零,必须知道估计量的抽样分布和标准误。
- 总体参数 β0,β1:未知、固定的真实参数。
- 估计量 β^0,β^1:随抽样变化的随机变量。
- 估计值:从这一组实际样本计算出的具体数字(如 0.67)。
- 标准误 se(β^j):估计量抽样波动大小的估计值;越小通常代表估计越精确。
2. 本堂课用到的基本假设#
课件从OLS估计量服从正态分布出发,其依据来自教材§2.3。常规经典线性回归讨论包括:
- 模型函数形式与解释变量的选取恰当;
- X 在样本中有变异(∑(Xi−Xˉ)2>0);
- 随机干扰项条件均值为零:E(μi∣X)=0;
- 随机干扰项具有条件同方差 Var(μi∣X)=σ2,不同观测间无条件相关(在给定解释变量后);
- 做经典小样本精确 t 推断时还使用条件正态性 μi∣X∼N(0,σ2)。
这里 X 表示给定的解释变量样本向量。前述假设成立时,β^j 对总体参数无偏,且具有相应的抽样分布;有关假设失效会影响传统标准误和显著性检验的可靠性。
3. OLS估计量的方差#
记 Sxx=∑(Xi−Xˉ)2=∑xi2,则条件于解释变量样本:
β^1∣X∼N(β1,Sxxσ2)β^0∣X∼N(β0,σ2[n1+SxxXˉ2])所以真实标准差为:
sd(β^1∣X)=Sxxσ,sd(β^0∣X)=σn1+SxxXˉ2总体误差方差 σ2 未知,用残差估计:
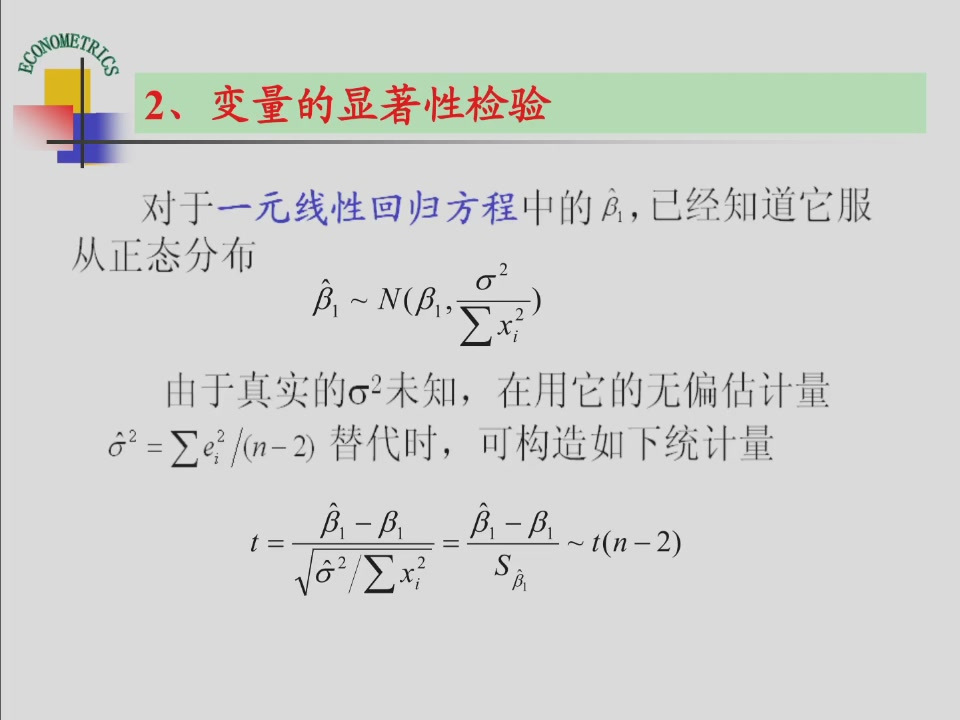
σ^2=n−2∑ei2=n−2RSS自由度 n−2 的来源:样本中估计了截距 β0 与斜率 β1 两个参数,残差因此满足两项OLS约束。
将 σ 替换为 σ^,得到实际可算的标准误:
se(β^1)=Sxxσ^2se(β^0)=σ^2(n1+SxxXˉ2)TIP记住斜率标准误的结构:
se(β^1)=∑(Xi−Xˉ)2σ^
在其他条件相近时,残差波动越小、X 的离散程度越大,估计斜率通常越精确。
三、变量的显著性检验(教材 §2.4)#
1. 假设检验到底在检验什么?#
回归分析希望判断:解释变量 X 对被解释变量 Y 的总体线性关系是否显著。对于一元回归,关键是检验总体斜率 β1。
原假设(Null hypothesis)与备择假设(Alternative hypothesis):
H0:β1=0,H1:β1=0
- H0:总体线性回归斜率为零;
- H1:总体线性回归斜率不为零;
- 零假设下,样本斜率即使不完全为零,也可能来自抽样误差。
2. 检验思想:反证法与“小概率事件”#
按照课件的表述,假设检验的直觉是:先按 H0 成立来计算概率,再观察样本结果是否过于极端。
若 H0 成立时,如此极端的统计量很难出现,就倾向于拒绝 H0。但要注意:拒绝或不拒绝原假设始终存在统计错误的可能。
- 第一类错误:H0 实际正确,却拒绝了它;显著性水平 α 控制此错误的概率。
- 第二类错误:H0 实际错误,却没有拒绝它。
- 不拒绝 H0 只表示当前证据不足以拒绝它,不能推出 H0 已被证明为真。
3. 构造 t 统计量#
若检验一般假设 H0:β1=β1∗:
t=se(β^1)β^1−β1∗∼t(n−2)(H0下)检验是否等于零时,β1∗=0:
t=se(β^1)β^1这一比值表示:估计值距离零有几个标准误。绝对值越大,越不容易用抽样波动来解释。
同样可以检验截距项:
t0=se(β^0)β^0−β0∗
为什么是 t(n−2)?由于 σ 未知,需要用 σ^ 代替;在经典正态假设下,标准化估计量便服从自由度为 n−2 的 t 分布。
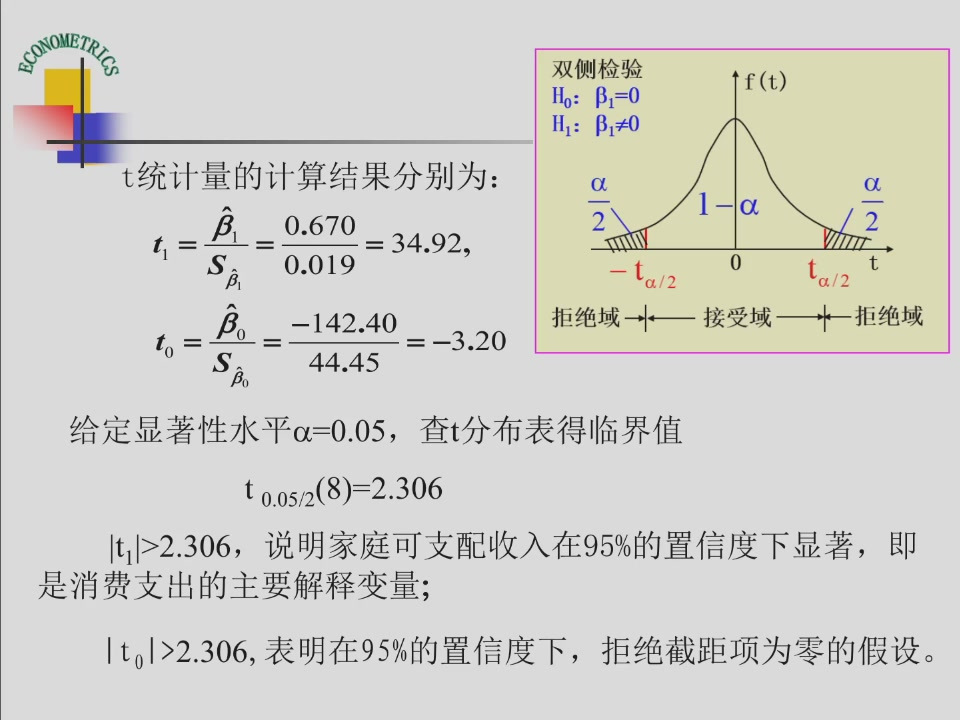
4. 临界值法(双侧检验)#
以 H0:β1=0、H1:β1=0 为例:
- 指定显著性水平 α,常见取值为 0.10、0.05、0.01。
- 计算 tobs=β^1/se(β^1)。
- 查 t 分布表,找到自由度 n−2 下的双侧临界值 tα/2,n−2。
- 当 ∣tobs∣>tα/2,n−2 时,拒绝 H0;否则不拒绝。
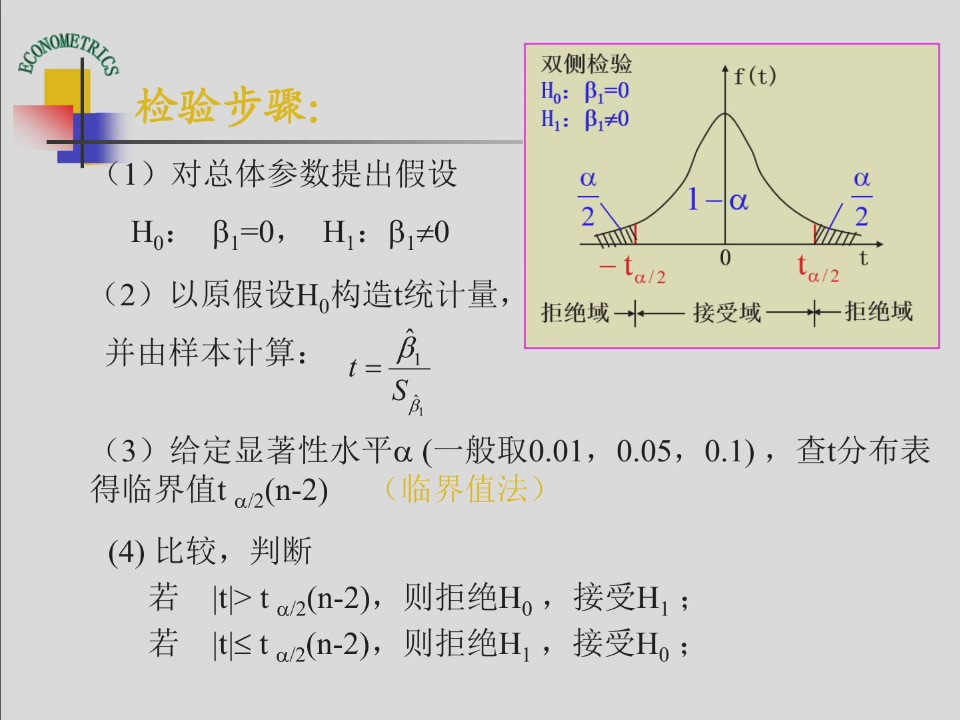
图示中,两端各留出 α/2 的拒绝域,中间为概率 1−α 的不拒绝域。
WARNING课件说“接受 H0”时,按较严谨的统计术语理解为未能拒绝 H0。在论文和作业中建议使用“拒绝/不拒绝原假设”的表述。
5. p 值法:与临界值法等价的另一种判断#
对于双侧检验:
p=P(∣Tn−2∣≥∣tobs∣∣H0)也就是:在 H0 成立的前提下,观察到至少和本次样本同样极端的统计量的概率。
- 若 p<α,拒绝 H0;
- 若 p≥α,不拒绝 H0。
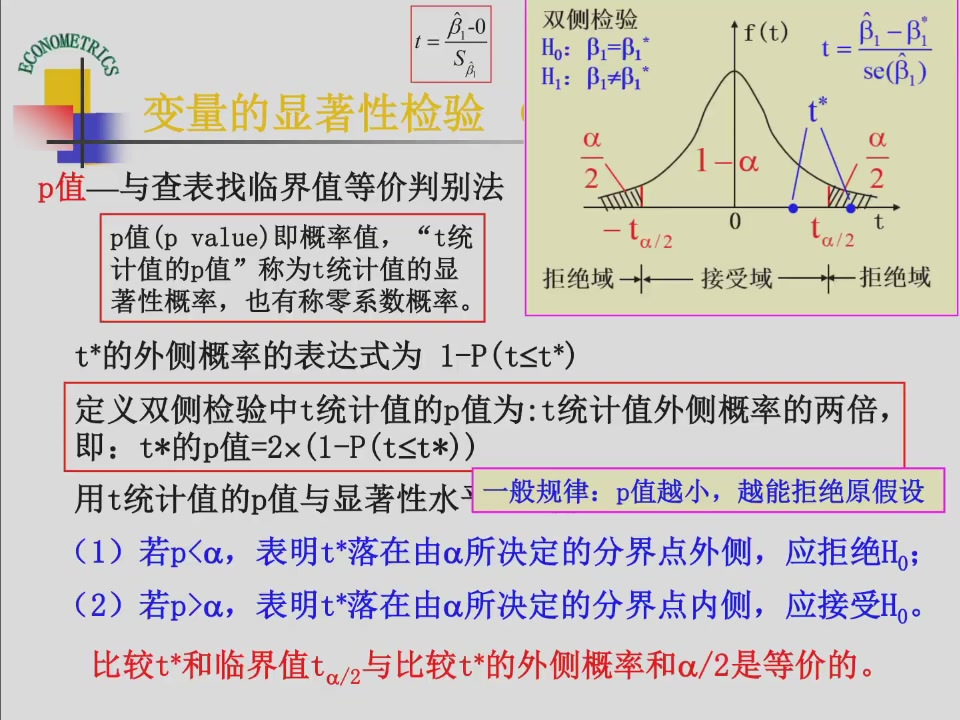
例:p=0.013。
- 与 α=0.05 比较:0.013<0.05,在5%水平下显著;
- 与 α=0.01 比较:0.013>0.01,在1%水平下未达到显著。
p 值的常见误解:p=0.013 表示“原假设为真的概率只有1.3%”是错误的。p 值的定义始终以原假设成立为前提。
四、课堂完整例题:家庭可支配收入与消费支出#
1. 题目与原始数据#
本节反复使用教材家庭“可支配收入 X—消费支出 Y”的10组观测值,构造线性模型:
Yi=β0+β1Xi+μi
| 家庭 i | 收入 Xi | 消费 Yi |
|---|
| 1 | 800 | 638 |
| 2 | 1100 | 935 |
| 3 | 1400 | 1155 |
| 4 | 1700 | 1254 |
| 5 | 2000 | 1408 |
| 6 | 2300 | 1650 |
| 7 | 2600 | 1925 |
| 8 | 2900 | 2068 |
| 9 | 3200 | 2266 |
| 10 | 3500 | 2530 |
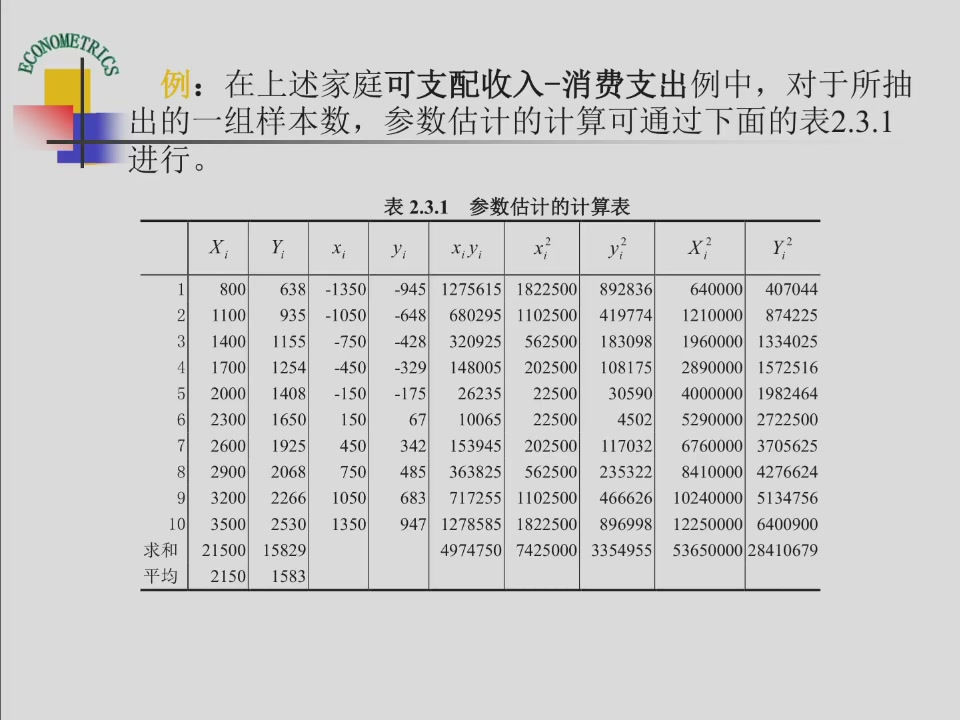
由原始数据计算(数据、输出以课件和教材表格为准):
n=10,Xˉ=2150,Yˉ=1582.9≈1583,Sxx=∑xi2=7425000,Sxy=∑xiyi=4974750,Syy=∑yi2=3354954.9.2. 第一步:用OLS计算回归系数#
β^1=SxxSxy=74250004974750=0.67β^0=Yˉ−β^1Xˉ=1582.9−0.67×2150=142.4因此:
Y^i=142.40+0.67Xi
- 斜率 0.67:样本中,可支配收入每增加1单位,平均拟合消费增加 0.67 单位。
- 截距 142.4:回归线在 X=0 时的拟合值;若样本不覆盖 X=0,其经济解释需要谨慎。
3. 第二步:计算 R2#
ESS=β^12Sxx=0.672×7425000=3333082.5RSS=TSS−ESS=3354954.9−3333082.5=21872.4R2=3354954.93333082.5≈0.9935解释:约 99.35% 的样本消费支出总平方离差可以由该样本线性回归解释,拟合优度很高。
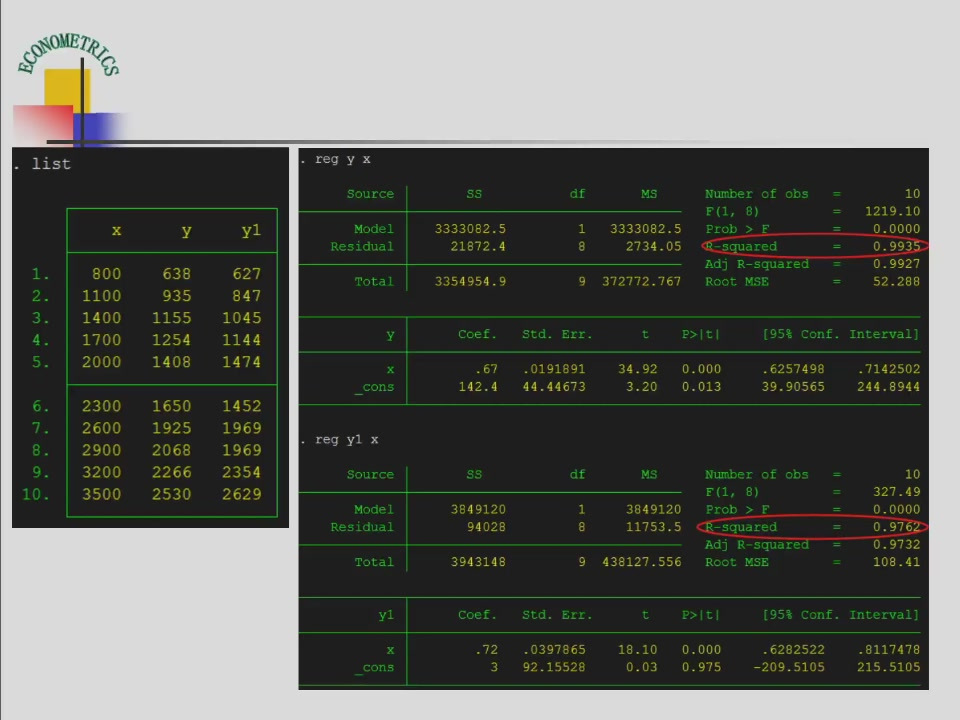
WARNING课件数值的精度差异
第3页把 R2 写成 0.9934,Stata 输出和教材采用 0.9935。根据所列精确平方和计算,四位小数应是 0.9935;复习时以原始平方和及Stata输出为准。
课件第2页同时展示 Y 与另一组 Y1 各自对 X 的回归:R2 约分别为 0.9935 与 0.9762。它们用于说明不同数据的拟合紧密程度。由于两次回归的被解释变量不同,不宜仅凭这两个 R2 排名来决定哪个模型更有经济解释力。
4. 第三步:估计随机干扰项的方差#
σ^2=n−2RSS=821872.4=2734.05由此:
se(β^1)=74250002734.05≈0.0191891se(β^0)=2734.05(101+742500021502)≈44.4467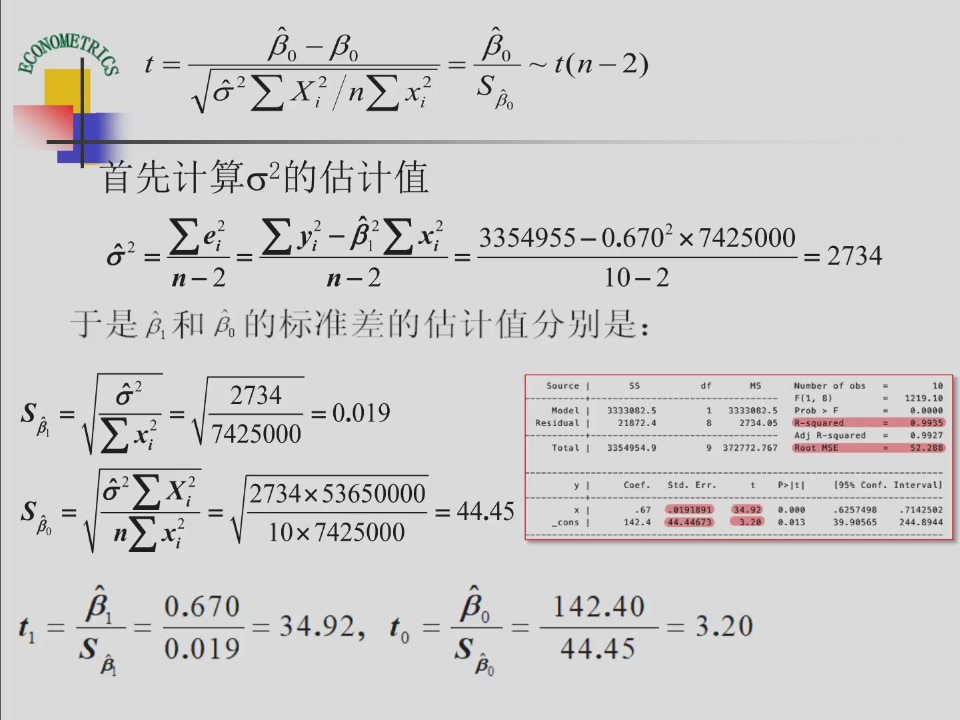
5. 第四步:显著性检验#
分别检验:
H0:β1=0与H0:β0=0用未过早舍入的标准误:
t1=0.01918910.67≈34.92,t0=44.4467142.4≈3.20设 α=0.05,df=n−2=8,双侧临界值为:
t0.025,8=2.306
- 斜率检验:∣34.92∣>2.306,拒绝 β1=0;可支配收入对消费的总体线性影响在5%水平下显著。
- 截距检验:∣3.20∣>2.306,拒绝 β0=0;截距在5%水平下显著。
WARNING两个需要辨认的课件排版 / 舍入问题
- 课件第13页有一处将截距 t0 计算式写成了 负号,但 β^0=142.4>0,标准误也为正,所以正确结果是 t0≈+3.20。即便做双侧检验时比较 ∣t0∣,也应确保统计量符号正确。
- 教材的部分演算先把斜率标准误简写为 0.019,于是出现 0.67/0.019≈35.26。Stata 使用更高精度标准误,得到 34.92。实际报告统计量时,建议保留充分精度再计算。
6. 用p值和回归输出再次核验#
课件Stata回归表给出:
| 参数 | 系数 Coef. | 标准误 Std. Err. | t | P>∣t∣ | 5%水平是否显著 |
|---|
| X | 0.67 | 0.0191891 | 34.92 | 0.000(显示精度) | 是 |
| 截距 | 142.4 | 44.4467 | 3.20 | 0.013 | 是 |
软件显示 0.000 或 0.0000 表示 p值极小、被四舍五入为零,并不代表数学上恰好等于零。截距的 p=0.013 表明其在5%水平下显著,在1%水平下不显著。
五、参数的置信区间(教材 §2.4)#
1. 为什么还要估计区间?#
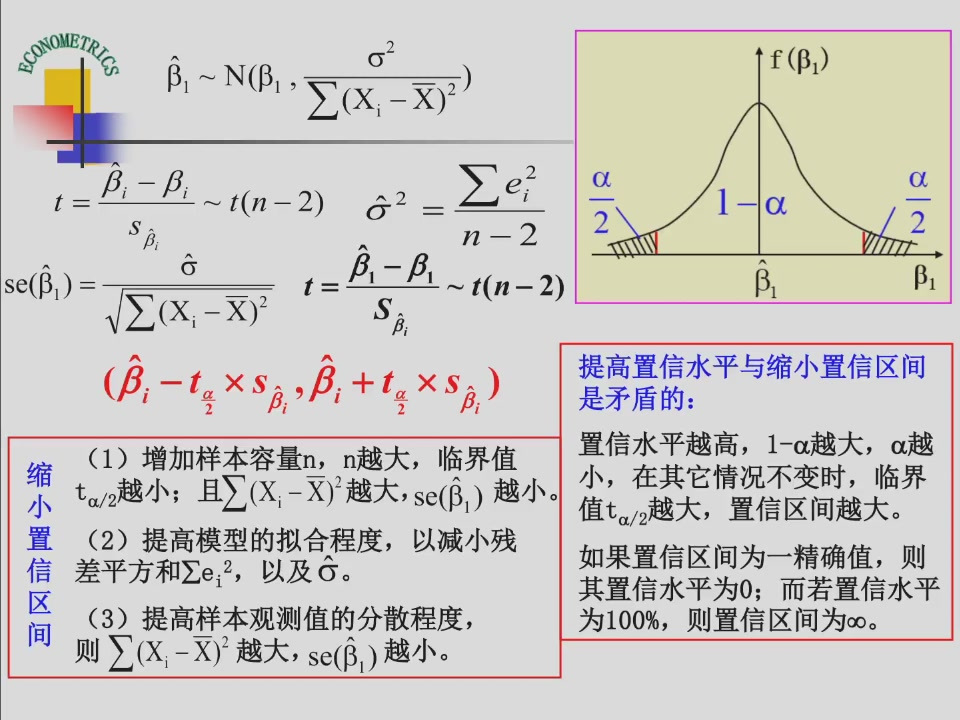
显著性检验关心能否拒绝某个假设值。参数的**区间估计(interval estimation)**则试图说明:在既定置信水平下,按照一个覆盖率受到控制的构造规则,可能得到多宽的参数区间。
课件先引入形式:
P(β^−δ≤β≤β^+δ)=1−α
这里应按重复抽样理解概率:总体参数 β 是固定值,随机性来自区间端点随样本变化。比如“95%置信区间”,严格地说,指采用这一构造方法反复抽样,长期来看约有95%的区间覆盖真实参数。
- 1−α:置信水平(confidence level),常见为95%、99%。
- α:显著性水平。
- tα/2,n−2:在双侧区间中使用的临界值。
2. 推导参数置信区间#
根据:
se(β^j)β^j−βj∼t(n−2)两侧各取 α/2,有:
P(−tα/2,n−2≤se(β^j)β^j−βj≤tα/2,n−2)=1−α把不等式移项,得到:
βj 的 (1−α)置信区间:β^j±tα/2,n−2se(β^j)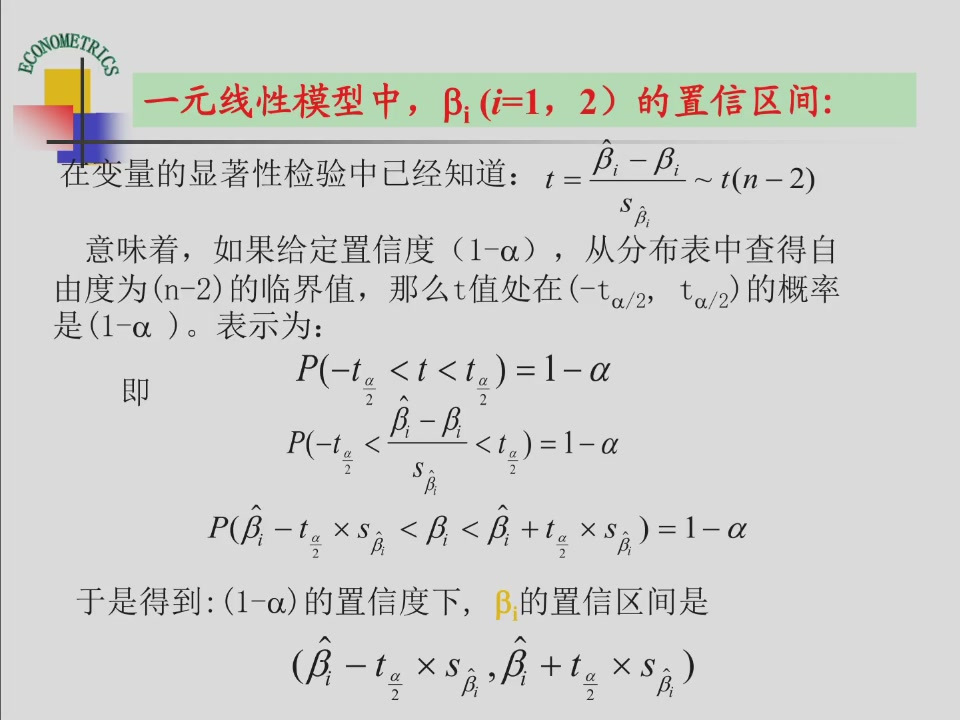
3. 课堂案例:99%参数置信区间#
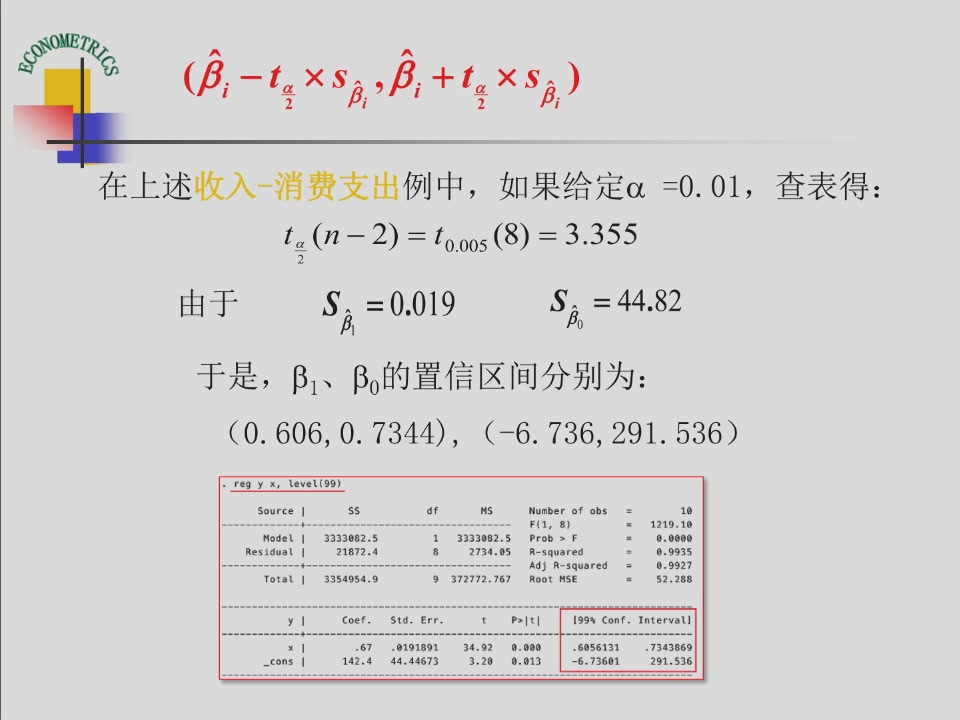
给定 α=0.01,自由度 df=8,查表得:
t0.005,8≈3.355387(表中常简写为 3.355)
对斜率:
0.67±3.355387×0.0191891≈(0.6056, 0.7344)对截距:
142.4±3.355387×44.4467≈(−6.736, 291.536)课件与Stata使用更精确的临界值,故截距区间端点约为 (−6.736,291.536);若先把临界值舍入成 3.355,区间端点会产生约 0.017 的差异。
结论:
- 斜率的99%置信区间不包含零,相应双侧1%显著性检验拒绝斜率为零。
- 截距的99%置信区间包含零,相应双侧1%显著性检验不拒绝截距为零。
- 95%置信区间会比99%区间窄,因为95%对应的临界值更小。
TIP置信区间与显著性检验的联系:对于检验 H0:βj=0 的双侧 t 检验,若同一置信水平 1−α 的置信区间不包含0,就在显著性水平 α 下拒绝 H0。
4. 什么因素会影响置信区间宽度?#
从半宽度 tα/2,n−2se(β^j) 出发:
- 增大样本容量 n:在常规可比条件下通常减小标准误,并使t临界值趋向正态临界值。
- 降低误差方差 σ2:样本观测更紧贴总体关系,参数标准误通常更小。
- 增加 X 的样本离散程度 Sxx:斜率标准误随之下降。
- 降低置信水平(如99%改为95%):临界值下降,区间变窄,但覆盖率要求同时降低。
课件第18页把“拟合程度提高”列为收窄区间的方向。理解时需要补上其他条件相同这一前提:单纯追求高 R2、扩大样本中的变量范围,并不能自动保证估计符合因果解释或经典假设。
六、Stata回归结果怎么看?#
课件第19页逐项标出了软件回归表,它将前面的所有统计量汇总在一起。
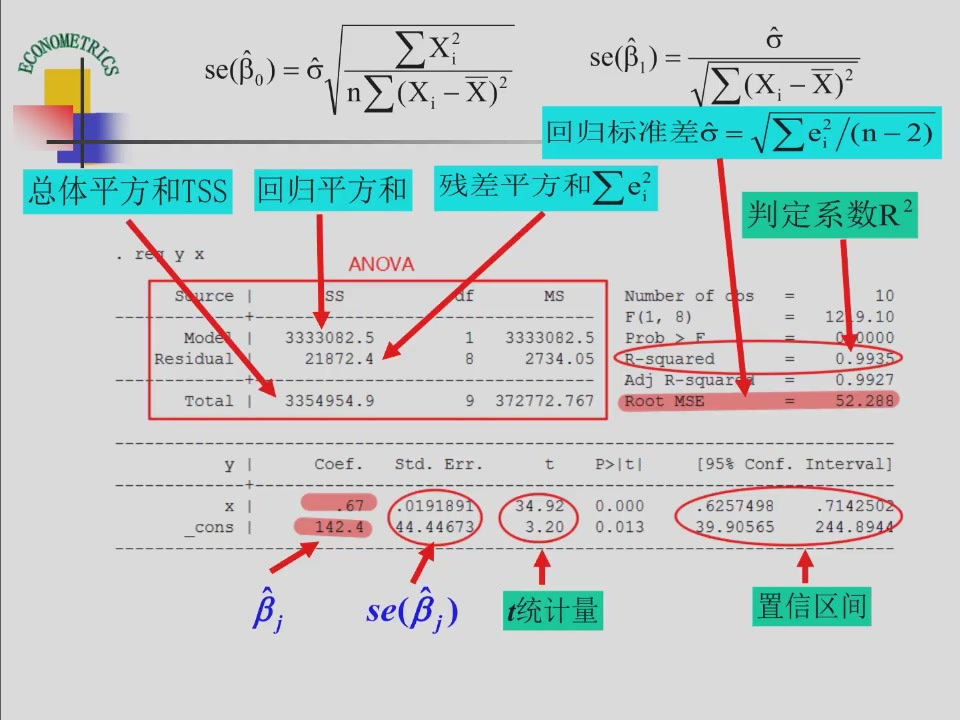
1. 回归表上半部分:平方和与整体拟合#
| Stata字段 | 本例数值(约) | 意义 |
|---|
Number of obs | 10 | 样本容量 n |
Model SS | 3,333,082.5 | 回归平方和 ESS |
Residual SS | 21,872.4 | 残差平方和 RSS |
Total SS | 3,354,954.9 | 总离差平方和 TSS |
Residual df | 8 | 残差自由度 n−2 |
Residual MS | 2734.05 | RSS/(n−2)=σ^2 |
Root MSE | 52.288 | σ^2=σ^ |
R-squared | 0.9935 | R2=1−RSS/TSS |
Adj R-squared | 0.9927 | 调整后的可决系数 |
F(1,8) | 1219.10 | 模型整体显著性检验的F统计量 |
Prob > F | 0.0000 | F检验的p值(显示精度) |
关于课件出现但本节没有重点推导的两个字段:
- 调整 R2:校正解释变量数目对普通 R2 的影响。对于含截距的一元回归,Rˉ2=1−TSS/(n−1)RSS/(n−2)。
- F检验:在一元含截距回归中,检验 β1=0 时有 F=t12,例如 34.922≈1219.4;因精度不同会略有差异。更系统的F检验会在多元回归中展开。
2. 回归表下半部分:系数与统计推断#
Coef.:β^j,参数估计值;Std. Err.:se(β^j),标准误;t:系数除以标准误(当 H0:βj=0);P>|t|:对应的双侧p值;[95% Conf. Interval]:系数的95%置信区间;_cons:常数项、截距 β^0。
本例中,如果只看到 x 的一行 0.67 / 0.0191891 / 34.92 / 0.000,就应立即能读出:估计斜率0.67,估计精度较高,拒绝斜率为0的原假设。
七、一元线性回归的预测问题(教材 §2.5)#
1. 两种预测对象:总体条件均值 vs. 总体个值#
这一节最容易混淆的地方是:给定 X=X0,我们可以预测两种对象。
A. 条件均值(conditional mean)
m(X0)=E(Y∣X=X0)=β0+β1X0
问的是:所有收入为 X0 的家庭,其平均消费会是多少?
B. 个别值(individual value)
Y0=β0+β1X0+μ0
问的是:某一个收入为 X0 的家庭,实际消费会是多少?
两者都使用同一个点预测:
Y^0=β^0+β^1X0区别在于:预测个别值时,除回归参数的估计误差外,还包含该个体自身的随机扰动 μ0。
2. 为什么 Y^0 是无偏的点预测?#
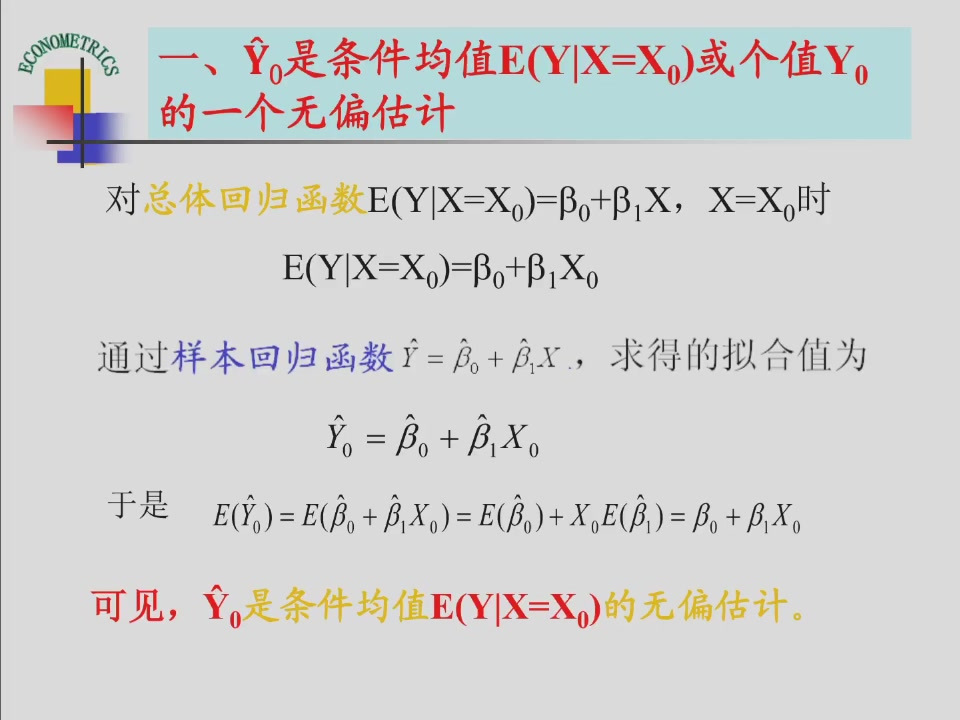
由OLS参数的无偏性:
E(Y^0∣X)=E(β^0∣X)+X0E(β^1∣X)=β0+β1X0=E(Y∣X0)在预测新个体时,若该个体随机扰动也满足零均值并与训练样本相应独立,那么:
E(Y^0−Y0∣X,X0)=0
因此 Y^0 对条件均值和新个体的真实值都具有无偏预测的性质;个体预测的实际误差仍然可能很大。
3. 条件均值预测的方差:为什么出现 1/n 与 (X0−Xˉ)2?#
先从:
Y^0=β^0+X0β^1
求方差(X0 给定):
Var(Y^0∣X)=Var(β^0∣X)+X02Var(β^1∣X)+2X0Cov(β^0,β^1∣X)由OLS:
Var(β^0∣X)Var(β^1∣X)Cov(β^0,β^1∣X)=σ2(n1+SxxXˉ2),=Sxxσ2,=−SxxXˉσ2.代入并合并平方:
Var(Y^0∣X)=σ2[n1+SxxXˉ2+X02−2X0Xˉ]=σ2(n1+Sxx(X0−Xˉ)2)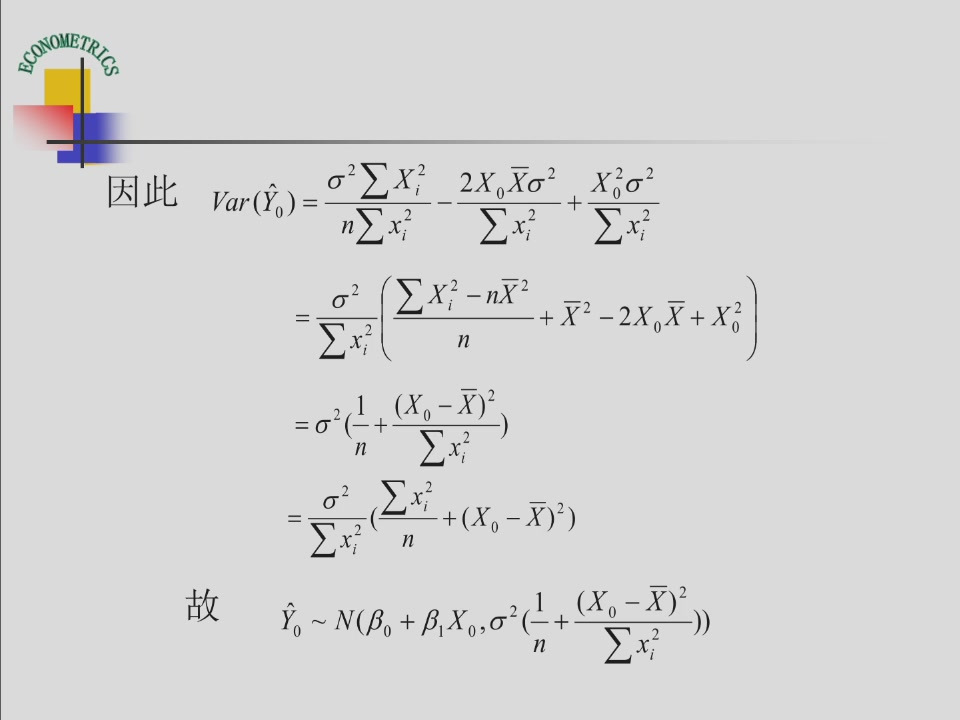
直观解释:
- 1/n:样本容量有限,平均水平仍有估计误差;
- (X0−Xˉ)2/Sxx:预测点 X0 越远离样本中心 Xˉ,估计直线的不确定性通常越大;
- Sxx 越大(在其他条件相近时),参数估计误差通常越小。
4. 条件均值的置信区间#
用 σ^2 代替 σ2:
semean(X0)=σ^n1+Sxx(X0−Xˉ)2故在 1−α 置信水平下:
Y^0±tα/2,n−2σ^n1+Sxx(X0−Xˉ)2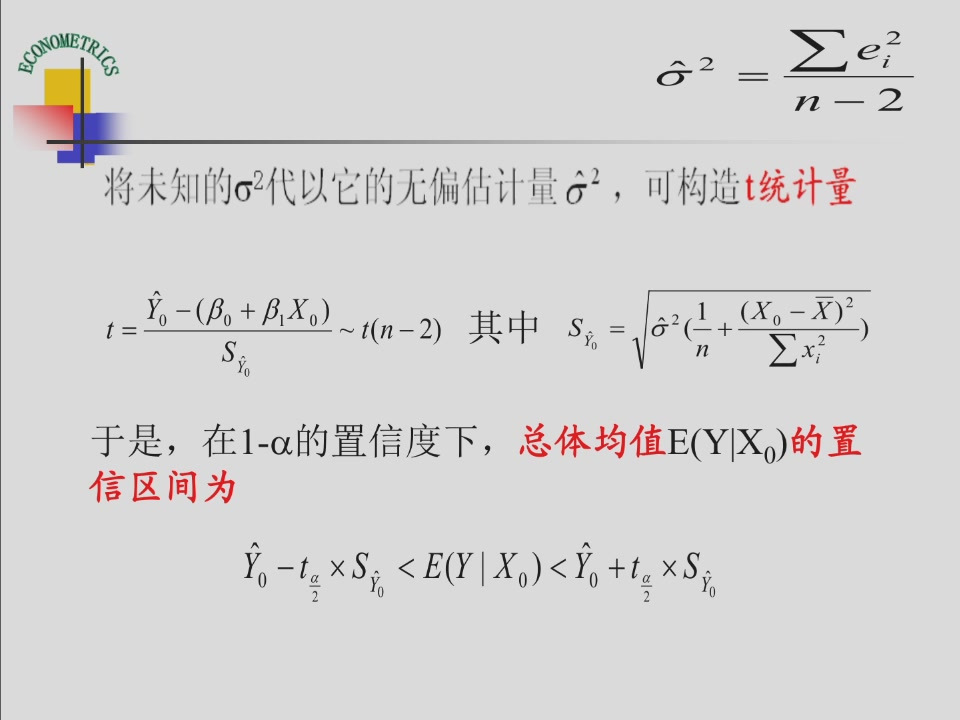
这条区间描述给定收入水平 X0 的平均消费可能落在哪个区间。
5. 个别值的预测区间:为什么比均值区间多了一个1?#
个别家庭的真实消费是:
Y0=β0+β1X0+μ0
预测误差:
Y0−Y^0=回归线估计误差[(β0+β1X0)−Y^0]+该家庭自身的随机波动μ0当新个体误差与估计样本相互独立、同方差时,两项方差可以相加:
Var(Y0−Y^0∣X)=σ2(1+n1+Sxx(X0−Xˉ)2)多出来的 1 对应新个体自身的随机误差方差 σ2。
于是其标准误为:
seind(X0)=σ^1+n1+Sxx(X0−Xˉ)2个别值预测区间(prediction interval):
Y^0±tα/2,n−2σ^1+n1+Sxx(X0−Xˉ)2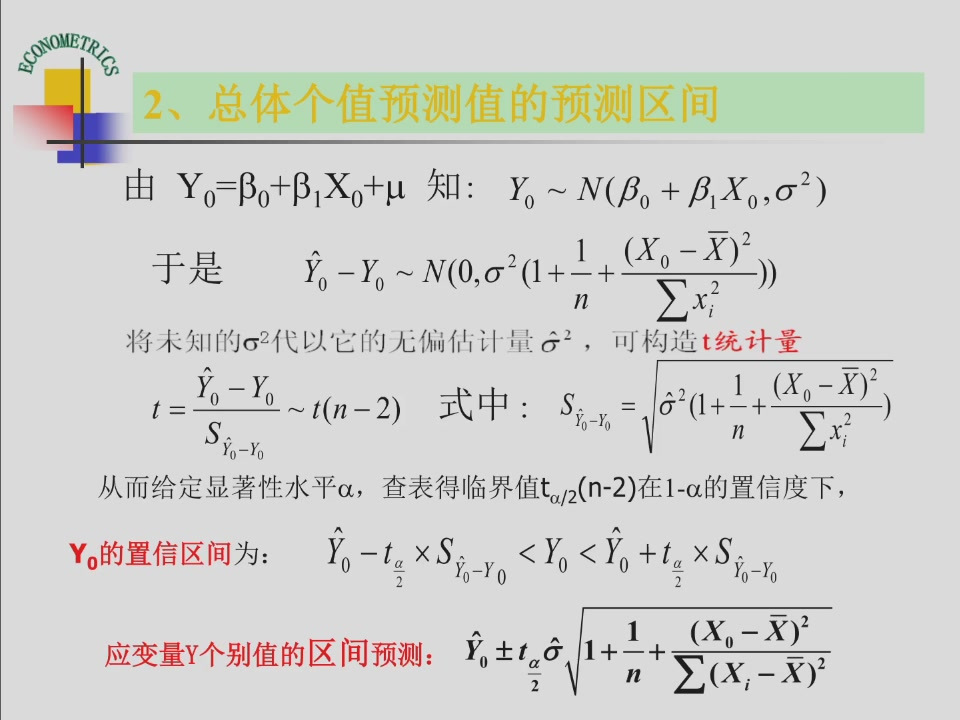
TIP最快记忆方法:
均值: σ^n1+Sxx(X0−Xˉ)2个值: σ^n1+Sxx(X0−Xˉ)2+1个值需要覆盖个体自己的不确定性,所以个值预测区间必然比对应均值置信区间更宽。
6. 教材案例的完整预测:收入 X0=1000#
沿用回归结果:
Y^=142.4+0.67X,n=10,Xˉ=2150,Sxx=7425000,σ^2=2734.05假设需要预测收入为1000的家庭消费:
Y^0=142.4+0.67×1000=812.4这既可用作该收入组的平均消费预测,也可作某个具体家庭消费的点预测。
(1)95%条件均值置信区间
semean=2734.05[101+7425000(1000−2150)2]≈27.6因为 t0.025,8=2.306:
812.4±2.306×27.6≈(748.8, 875.9)(2)95%个别值预测区间
seind=2734.05[1+101+7425000(1000−2150)2]≈59.1812.4±2.306×59.1≈(676.1, 948.7)比较:点预测相同,均值置信区间约宽127,个别值预测区间约宽273。单个家庭消费还有自身随机因素,所以可能偏离同收入组平均值更远。
两组数值与教材§2.5的 X0=1000 例子对应。保留的中间位数不同,端点可能存在约0.1的舍入差异。
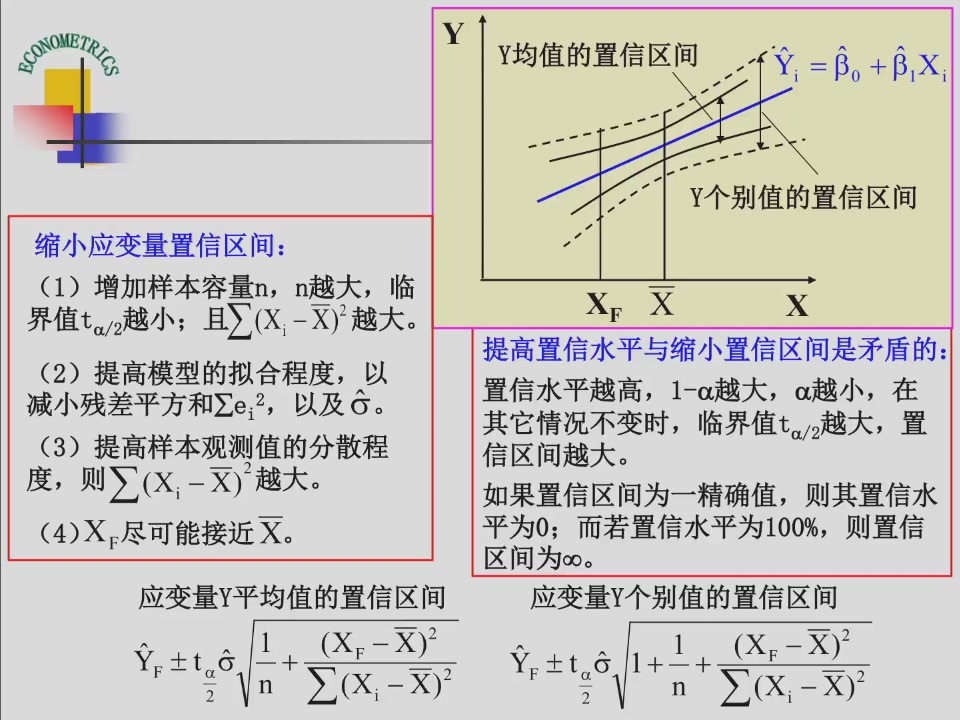
7. 预测区间的图形与宽度规律#
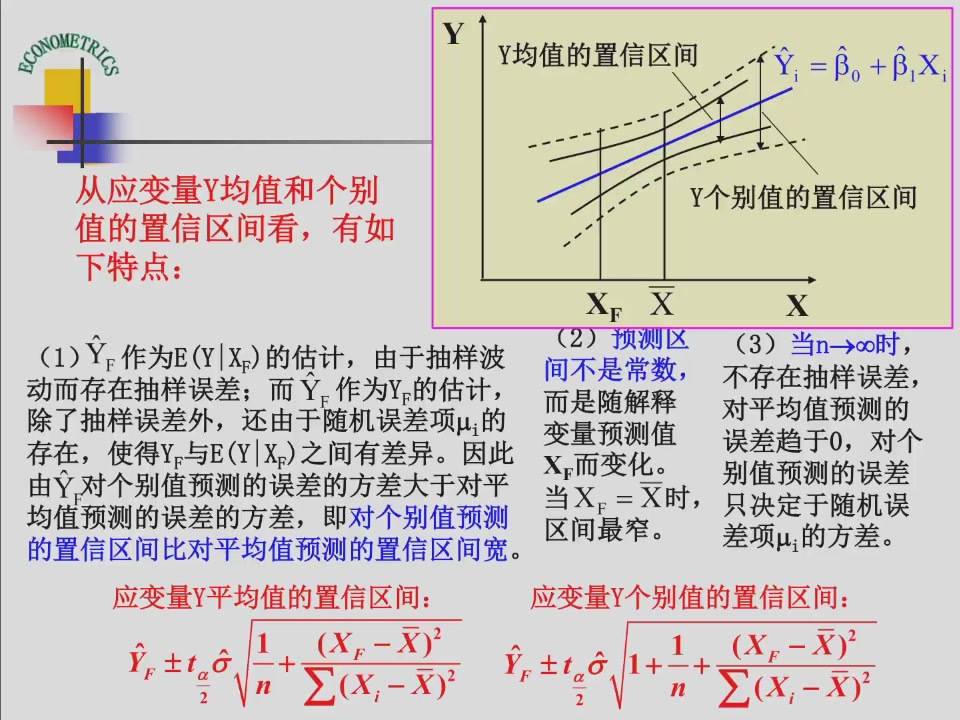
图中两条带状区域都围绕样本回归线分布:
- 中间较窄的带:条件均值的置信区间;
- 外侧较宽的带:个别值预测区间;
- 距离样本均值 Xˉ 越远,带越宽:更远处的预测更依赖估计斜率,估计不确定性增加;
- 在固定 n、Sxx、σ^ 和置信水平下,X0=Xˉ 时带宽最窄。
课件第29页还列出缩小区间的条件:增加样本容量、降低残差波动、增加解释变量样本分散程度、优先在 Xˉ 附近预测。对于位于样本观察范围以外的 X0,需要额外小心**外推预测(extrapolation)**可能遇到的函数形式失效问题。
八、公式辨析、易错点与复习总结#
1. 核心公式速查#
| 问题 | 应用的公式 | 含义 |
|---|
| 斜率OLS估计 | β^1=Sxy/Sxx | X变化1单位,Y的拟合变化 |
| 截距OLS估计 | β^0=Yˉ−β^1Xˉ | 回归线过 (Xˉ,Yˉ) |
| 总平方和分解 | TSS=ESS+RSS | 需含截距项的OLS |
| 可决系数 | R2=1−RSS/TSS | 样本拟合优度 |
| 误差方差估计 | σ^2=RSS/(n−2) | 两个参数占用两个自由度 |
| 斜率标准误 | se(β^1)=σ^/Sxx | 斜率精度 |
| 斜率t检验 | t=(β^1−β1∗)/se(β^1) | 与假设值相差几个标准误 |
| 参数置信区间 | β^j±tα/2,n−2se(β^j) | 参数的不确定范围 |
| 点预测 | Y^0=β^0+β^1X0 | 均值与个值同一个中心 |
| 均值区间SE | σ^1/n+(X0−Xˉ)2/Sxx | 平均响应估计精度 |
| 个值区间SE | σ^1+1/n+(X0−Xˉ)2/Sxx | 另加新个体扰动 |
2. 最容易混淆的五组概念#
(1)拟合优度与显著性
- R2:当前样本中,回归线解释了多少 Y 的平方离差;
- t / p:关于总体斜率的假设是否被当前样本证据拒绝。
(2)估计值与标准误
- β^1=0.67:估计的影响大小;
- se(β^1)=0.0192:斜率估计的不确定性。
(3)显著性水平与p值
- α:分析者预先给出的判断阈值;
- p:按原假设和实际样本统计量算出的尾部概率。
(4)参数置信区间与预测区间
- 参数区间:针对未知的 β0,β1;
- 均值区间:针对 E(Y∣X0);
- 个值区间:针对未来某一个 Y0。
(5)统计显著与经济显著
- 统计显著说明样本证据有助于排除某个假设值;
- 经济显著还需结合系数大小、单位、理论机制和识别条件判断。
3. 做题时的标准步骤#
针对一元线性回归的综合题,推荐按以下顺序:
- 写出模型及 n,Xˉ,Yˉ,Sxx,Sxy,Syy;
- 求 β^0,β^1,写出样本回归方程;
- 求 ESS,RSS,R2,解释拟合优度;
- 求 σ^2 与 se(β^0),se(β^1);
- 列出 H0,H1,α,计算 t 或 p,用“拒绝/不拒绝”给结论;
- 根据置信水平计算参数区间;
- 如需预测,先判断目标是均值还是个体,再选择正确的标准误公式。
WARNING课件及公式使用边界
- R2∈[0,1] 和 R2=r2 均有特定的含截距OLS前提。
- 小样本 t 检验与预测区间的精确结论依赖经典模型假设;大样本推断还需相应的渐近条件。
- p<α 意味着在给定检验下拒绝原假设,不直接证明因果关系。
- R2 高、斜率显著,都不能排除遗漏变量、内生性、函数形式错误。
- 预测个别值时,公式根号内必须有额外的 1。
九、自主巩固(非教师布置作业)#
目前提供的材料无法核实老师是否口头指定了教材习题,因此本节仅给出直接对应课堂内容的自测与解答,供复习;不将其列为课程正式作业。
自测1|教材本章练习“证明一元回归的 R2=r2”#
题目(依据教材第2章练习有关要求整理):证明一元含截距OLS回归中的可决系数 R2 等于 X,Y 样本相关系数 r 的平方。
解答:
β^1=SxxSxy,ESS=β^12Sxx=SxxSxy2从而:
R2=TSSESS=SxxSyySxy2=(SxxSyySxy)2=r2要点:用到离差形式、样本平方和分解和包含截距的OLS性质。
自测2|同时判断显著性与区间结论#
题目:样本量 n=10,得到某回归截距 β^0=142.4,其标准误为 44.4467。H0:β0=0,给定 α=0.05,t0.025,8=2.306;若改为99%置信水平,t0.005,8=3.355。问:是否在5%水平下显著?99%参数区间是否包含零?
解答:
t=142.4/44.4467≈3.20>2.306因此在5%水平下拒绝 H0。
99%区间为(使用未提前舍入的临界值):
142.4±3.355387×44.4467≈(−6.736,291.536)
包含零,因此在1%水平下不拒绝 H0。两个结论完全相容,因为检验标准不同。
自测3|区分两类预测#
题目:在同一个 X0 处,为什么均值置信区间与个值预测区间具有相同中心,但个值区间更宽?
解答:两者均用 Y^0=β^0+β^1X0 做点预测,区别在于个值还包含新个体的 μ0。若新个体误差和训练样本相应独立、具有方差 σ2,预测误差方差就比均值估计误差方差多 σ2,所以标准误公式根号中多一个 1,区间更宽。
资料定位#
- 课堂资料:孔伟杰,计量经济学第5次课,2026-10-13;课件PPT第1—29页(第30—33页是课堂电脑画面)。
- 教材:李子奈、潘文卿,《计量经济学》(第五版),高等教育出版社,2020,第2章:§2.2、§2.3、§2.4、§2.5。尤其参考教材图2.2.1、家庭可支配收入—消费支出例题、§2.5 X0=1000 预测例题。
- 使用说明:正文配图均采用 Astro 静态绝对路径
/images/econometrics/lesson5/...。应将随附 public/images/econometrics/lesson5/ 放入 Astro 项目根目录的对应位置。本文公式采用 Markdown 中的 KaTeX/MathJax 常用写法,需网站已启用相应数学公式渲染支持。
